RSI 综述 3|Harness 层,Agent 怎样改进自己的工作方式
Harness 层的自我进化已经同时发生在工作流搜索、持久状态更新和可写运行时中。MiniMax、Prime Agent 与 DeepSeek 展示了三种工程路线,也暴露出同一条边界,产生修改的系统不能同时掌握最终判断。
Harness 自我进化的业界尝试
2026 年,Harness 开始从人写给 Agent 的固定脚手架,变成 Agent 自己可以检查、修改和重新运行的对象。半年时间里,模型外面的 prompt、memory、skill、workflow 和完整 runtime 都有人动手改了。
3 月,MiniMax M2.7 在一套内部软件工程 Harness 上连续运行 100 多轮。它读失败轨迹,修改 Agent 架构、skills、MCP 和 memory,再跑评测决定保留或回退。最后留下的改动包括循环检测、采样参数,以及“修完 bug 后继续搜索其他文件里的同类模式”。MiniMax 报告内部评测提高了 30%。
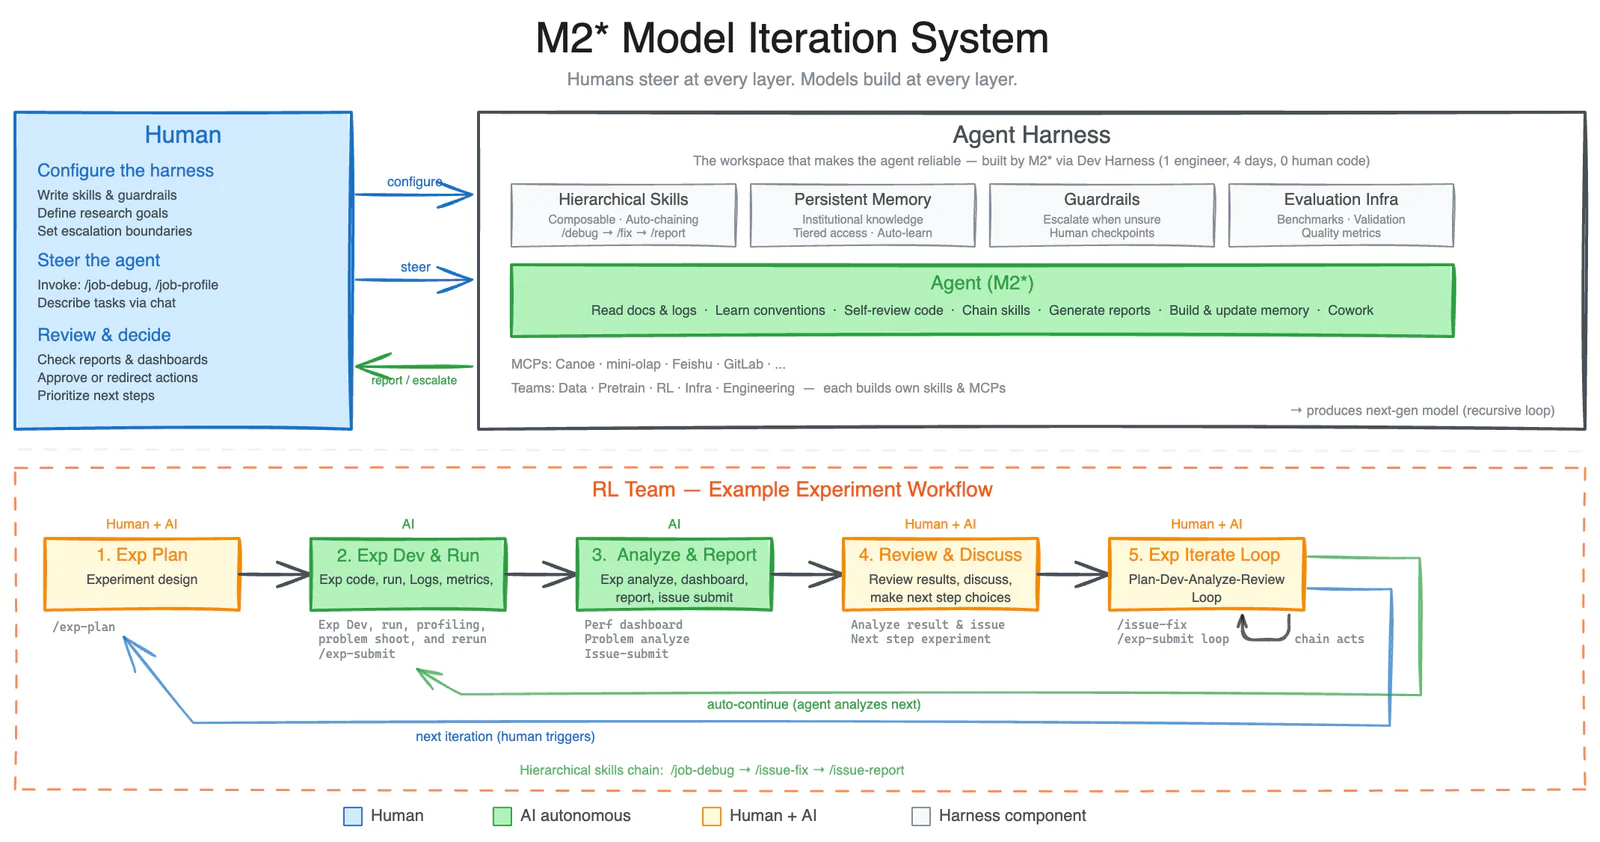
5 月,Continual Harness 把这件事写成双层适应。内层在一次不重置的长任务里反复修改 prompt、memory、skill 和 subagent,外层再把优质轨迹送去更新模型。几天后,Prime Intellect 发布 Prime Agent v0.0.1,把内层循环做成 /refine。它冻结 base prompt 和模型权重,只允许 Agent 修改四类 supplemental state,并为每次修改留下 evidence、before/after、作用域与 rollback。
Prime Agent 尤其适合拿来学习 Harness RSI。它没有只画一张自进化架构图,而是把什么能改、什么时候改、改完写到哪里、出错怎样撤回都落进代码。
同在 5 月,Microsoft 联合多所高校提出 SkillOpt,把一份 skill 文档当作外部参数,用带分数的 rollout 生成小步编辑,再由 validation gate 决定是否提交。6 月,上海人工智能实验室发布 Self-Harness,让同一个固定模型从自己的失败轨迹里找弱点,再给自己提出 Harness 修改。
7 月,翁荔发表《Harness Engineering for Self-Improvement》,把 prompt、context、workflow、Harness code 与 optimizer code 放进同一条演进路径。Weco 的 AIDE² 让外层 autoresearch Agent 重写内层 Agent 的 Harness 代码,100 步连续运行八天。Sakana AI 与 UC Berkeley 的 Recursive Harness Self-Improvement 则用成对反馈反复改写 prompt 级 Agent loop。
8 月 17 日,DeepSeek Harness 发布首个 developer preview。它把 model、tool、skill、session、sandbox、storage、loop、scheduler 和 UI 全部做成 Cordis plugin。Creator mode 允许 Agent 检查当前 runtime,创建或修改 plugin,运行新版本,失败后修复或回滚,也能把试验结果写成跨会话使用的新 preset。
同一时期,Hermes Agent 也在改经验怎样留下来。它会在持续工具操作后触发 skill review,再用 active、stale 和 archived 管理技能生命周期。
把这些工作并排放在一起,Harness RSI 的形状才完整。
| 系统 | 主要修改对象 | 修改何时发生 | 保留依据 |
|---|---|---|---|
| MiniMax M2.7 | Scaffold 代码、Agent loop、skills、memory | 长程研发实验中连续搜索 | 内部评测与保留/回退 |
| Prime Agent | Prompt、memory、skill、subagent | 手动 /refine,或自动 review gate 通过后 | 轨迹证据、结构校验、版本记录 |
| DeepSeek Harness | Tool、service、event、UI 与完整 plugin | 当前进程中动态定义和运行 | Diagnostics、mount validation、人工权限 |
| SkillOpt | 单份 skill 文档 | 离线 rollout 后批量编辑 | Validation score 严格提升 |
| Self-Harness | 针对目标模型的 Harness 规则 | Weakness mining 之后 | Regression gate |
| Hermes Agent | Skill 库 | 长程使用中定期复盘 | 使用记录与生命周期状态 |
| RHI / AIDE² | Agent loop 或 Harness code | 外层 optimizer 递归改写 | 成对评估或 private score |
这些系统的可修改范围,从一份 skill 文档一直扩到整套 runtime;更新节奏,从离线优化一直走到运行中的自修改;判断信号,也从模型自评走到 verifier、private score 和 hidden test。
这就是 Harness 层的自我进化。
Harness 改的是下一次任务的起点
翁荔对 Harness 的定义很接近今天真实的 Agent 工程。Harness 是模型周围的执行系统。它决定模型看见哪些上下文,怎样规划和调用工具,状态写到哪里,任务怎样分给子 Agent,结果由谁检查,失败以后如何恢复。
Prompt 只是其中一个部件。Memory 保存事实和历史,skill 保存可复用流程,tool 定义动作,workflow 编排步骤与分支,runtime 还要处理并行、权限、上下文和持久状态。这些对象可以是自然语言,也可以是代码。分类只看哪个持久状态发生了变化。
把 Agent 写成 ,这层实验会固定模型 、任务环境和 evaluator,只允许 Harness 改变。Agent 执行任务后留下证据 ,evolver 据此提交一项更新。
模型、环境和评分规则一起变化,分数就无法归因。Harness self-improvement 的第一条实验纪律,是把 单独变成可测量的更新对象。
Harness 位于两种经验载体之间。Artifact 保存当前答案,交付后通常结束。模型权重能把经验带到大量任务里,却难以逐条查看和删除。Harness 可以跨任务复用,又保留 diff、作用域、版本和回滚。
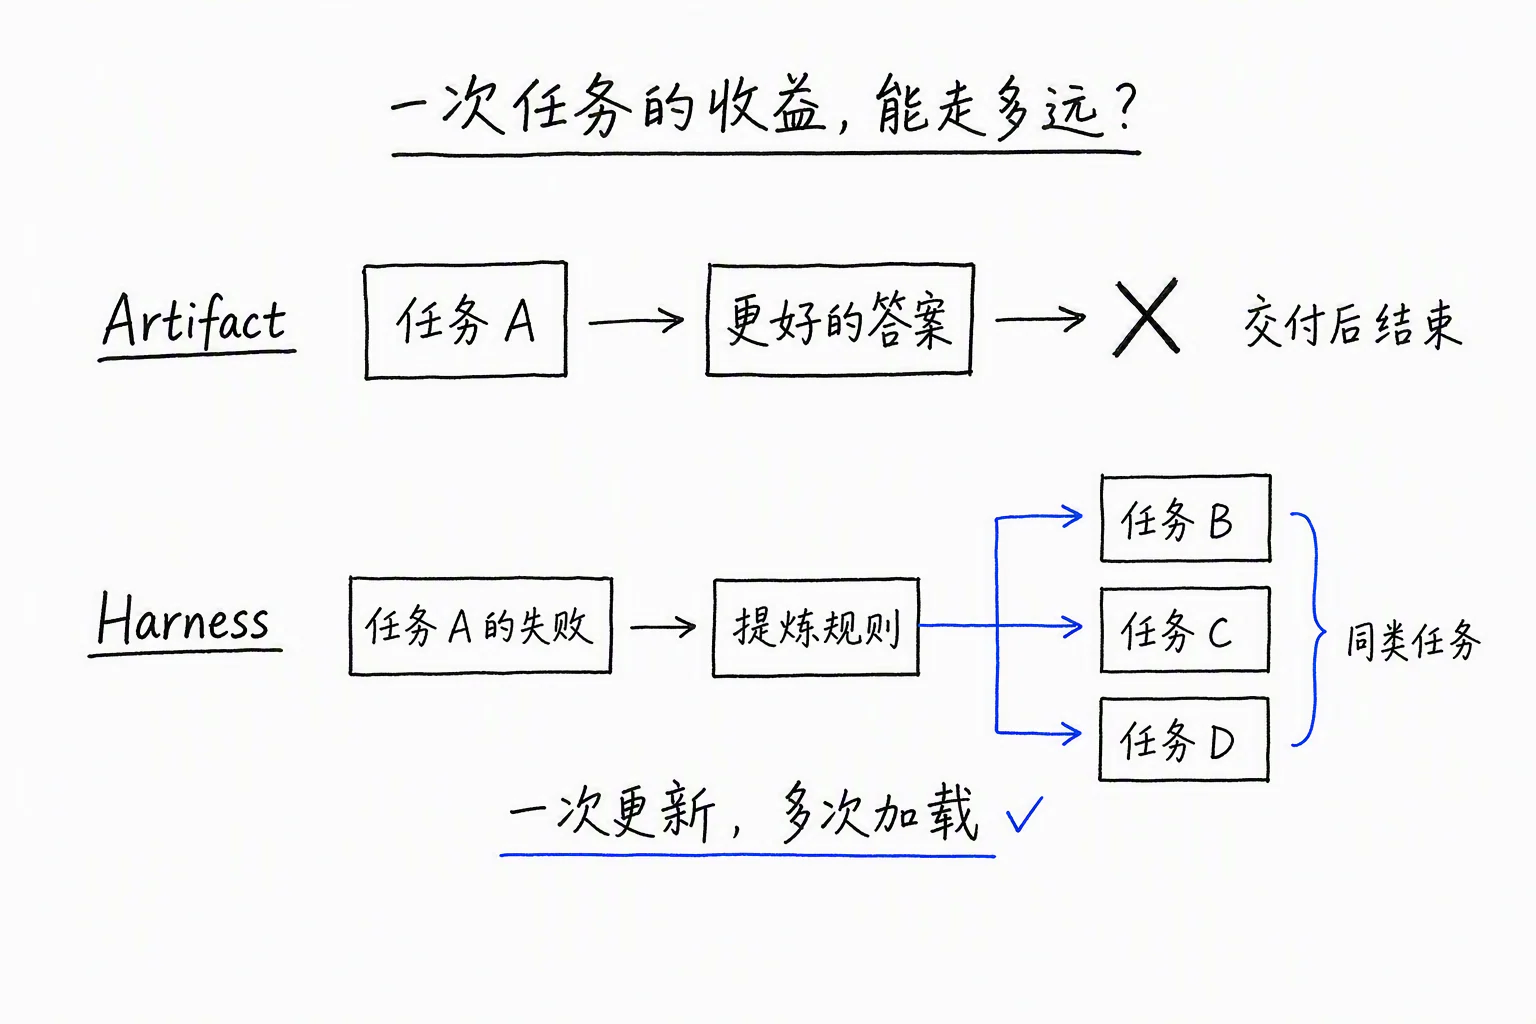
一条新规则可以先进入 session,只影响当前运行;反复成立以后升到 project;跨项目仍然有效,再进入 global。错误经验在小作用域里暴露,删除一条记录就能退回去。
便宜和可逆,让 Harness 成了今天最容易高频试错的经验层。
三种工程路线怎样改 Harness
三套工程系统把可修改范围放在了不同位置。MiniMax 搜索整套研发 scaffold,DeepSeek 打开 plugin runtime,Prime Agent 只开放四类持久状态。它们沿着同一条尺度展开,修改面越大,系统能解决的问题越多,归因和权限也越难控制。
MiniMax 用长程搜索改 Harness
MiniMax 的案例有两层循环,容易被一句“内部评测提高 30%”盖过去。
外层循环服务模型研发。MiniMax 把数据流水线、训练环境、评测基础设施、跨团队协作和持久记忆接进一个研究型 Agent Harness。研究员提出实验方向,Agent 查资料、维护实验规格、准备数据、启动训练,再盯日志和指标。实验出问题以后,它继续排查、改代码、提合并请求和跑冒烟测试。官方估计 M2.7 在一类强化学习研发场景里可以承担 30% 到 50% 的工作流。
这时 Harness 已经不只是模型的工具箱。它开始像研发组织的执行层,把一次想法变成数据、代码、训练任务和评测结果,再把结果送回下一轮决策。模型参与制造下一代模型,但关键判断仍由研究员和训练评测系统掌握。
内层循环更接近纯粹的 Harness RSI。MiniMax 让 M2.7 优化一套内部软件工程 scaffold,连续运行下面这套流程超过 100 轮。
分析失败轨迹
      ↓
规划一项修改
      ↓
修改 scaffold 代码
      ↓
运行评测并比较
      ↓
保留或回退
留下来的修改落在三个不同位置。
第一类改采样行为。Agent 系统搜索 temperature、frequency penalty 和 presence penalty 的组合。这类参数没有增加新知识,却会改变探索范围和重复倾向。
第二类改工作流规则。例如修完一个 bug 后,继续搜索其他文件里的同类模式。这条规则把一次漏修变成跨文件检查步骤,改变的是下一次任务的默认动作。
第三类直接改 Agent loop。循环检测被写进 scaffold 后,Agent 不必靠模型临场意识到自己在重复。失败模式从 prompt 建议升成运行时约束。
这三个位置正好覆盖 Harness 的三层控制面。采样参数调整行为分布,workflow 安排动作顺序,runtime code 负责硬约束。MiniMax 的 30% 内部增益来自对多个可修改面的联合搜索。
MiniMax 还在 MLE-Bench Lite 的 22 个机器学习任务上做了三次 24 小时实验。每轮结束后,Agent 写短时记忆和自反馈,下一轮读取全部历史再决定实验方向。官方披露三次平均得牌率为 66.6%,最好一次拿到 9 金、5 银、1 铜。
这组材料证明 Harness 可以支撑长时间、多轮次、跨组件的自主搜索。证据边界也很清楚。30% 来自项目方内部评测,代码、任务切分、候选预算和失败版本没有公开。MLE-Bench 的收益里还混有更多实验尝试,不能全部归到 Harness 学习。
MiniMax 做成的是一台能持续转动的改进机器。它证明一百轮以后系统仍能提出、执行和筛选修改;每项修改能否迁移到新仓库,还需要独立测试。
DeepSeek 把整个运行时变成可写插件
DeepSeek Harness 把“Agent 修改 Harness”拆成了一组模型可以直接调用的动作。官方页面用两句话概括这套设计。
Everything is a plugin. Every run is traceable.
Cordis 里的 plugin 不是一个孤立工具。它可以提供 service、订阅 event、注册模型可见的 tool、贡献 system prompt,也可以占用浏览器 UI slot。Agent 这一轮能调用什么、下一轮 prompt 里多出什么,都取决于当前挂载的 plugin graph。修改图中的一个节点,执行环境就跟着变。
Creator mode 的预设文件直接告诉模型,“你可以读取并修改自己正在运行的 Harness”。它挂载了五个 self-referential tools。
cordis_inspect 读取当前进程真实运行的 services、events、tools、dynamic packages 和 UI slots。报告不只来自静态文档。系统会把编译期生成的 API catalog 与 live service store 相交,模型因此能区分“仓库里定义过”与“这个进程里确实可调用”。
另外四个动作负责 package 生命周期。cordis_define 记录并检查代码,cordis_run 才把它装进 live runtime;cordis_stop 停止运行但保留定义,cordis_undefine 连定义一起删除。定义与执行被拆开,Agent 写完代码以后还有一个明确的启动点。
一次修改按下面的顺序发生。
inspect 当前 runtime
        ↓
define 新 plugin 或现有 plugin 的新 Package
        ↓
run / update 指定版本
        ↓
读取 diagnostics 与运行结果
        ↓
继续修复、stop,或切回旧 Package
cordis_define 不会覆盖旧代码。新建 plugin 时,它生成第一个 immutable Package;修改现有 plugin 时,它在原 plugin 下追加新 Package。cordis_run 用 update 切换版本,用 run 重新启用当前版本或回滚旧版本。运行失败后,Agent 可以读回这一版的源码和 diagnostics,修正后再提交一版。
新 plugin 可以注册一个工具,也可以监听一次任务事件、改写 prompt contribution,或者给 UI 增加新的交互面。它改变的不只是已有工具的参数,而是 Agent 下一轮可以采取的动作集合。这个差别让 DeepSeek Harness 比 prompt optimizer 更接近递归系统。
这套自修改有快慢两种状态。动态 Package 只存在于当前 DSH 进程内,由创建它的 session 控制。它可以跨后续 turn 生效,重启、stop 或 undefine 以后就会消失,也不能自动晋级为持久插件。这个限制把现场实验和永久能力分开了。
需要跨会话保存时,Creator mode 会复制一份可工作的 preset,再编辑其中的 agent.cordis.yml、skills 和 metadata。完成后不能只看 YAML 是否能解析。standingKeyFor(id) 会像真实 session 一样挂载整棵 plugin subtree,检查 package 是否存在、配置是否完整、依赖 service 是否激活,以及 plugin 有没有把本应隔离的 service 发布到进程根域。
运行证据也没有藏在聊天表面。DeepSeek Harness 要求所有模型可见内容都能从 append-only session log 重建,包括 system prompt、reasoning、tool call、result、subagent scheduling 和 context injection。Resume、fork、search 与 replay 都从这条事件流派生。
安全边界同样写在源码里。带 Client 代码的 Package 需要人批准;官方把动态插件工具视为与 shell access 同级的权限,因为模型写出的 JavaScript 会影响 live runtime。VM 隔离只是约束诚实代码,不是安全沙箱。Sandbox、approval 和 permission plugin 留在 host 一侧,Agent 编辑的 preset 不能把自己的权限边界一起放宽。
这套结构已经具有递归性。Agent 写出的 plugin 会改变下一步可见的工具、prompt 或运行规则,新能力又能参与后续修改。DeepSeek Harness 证明完整 runtime 可以成为可写状态。
它还没有提供一套通用的自动晋级标准。Diagnostics 能发现代码和依赖错误,mount validation 能证明 composition 可以运行,它们不能证明新插件让目标任务变好。DeepSeek 打开了自修改接口,最终判断仍要由外部 evaluator 接住。
Prime Agent 把自改限制在四类状态
DeepSeek Harness 打开整个插件运行时,Prime Agent 主动缩小了可修改面。这个取舍让它成了一份很适合读源码的 RSI 样本。模型能改变下一轮工作的方式,系统又能指出到底是哪条状态变了。
Prime Agent 由两个抽象拼起来。RLM 把长上下文当成 Python 变量,把子 Agent 当作可以从持久 IPython 环境里调用的函数。Continual Harness 则把能跨 turn 保存的工作方式放在模型外面。前者负责执行,后者负责学习。
这个区分很重要。IPython 里的变量、导入和中间结果能帮助当前长任务继续推进;Harness 里的规则准备影响未来任务。临时工作记忆和可复用经验不再混在同一个聊天窗口里。
源码里的 RefinementKind 只有四种值。
export type RefinementKind =
  "prompt" | "memory" | "skill" | "subagent";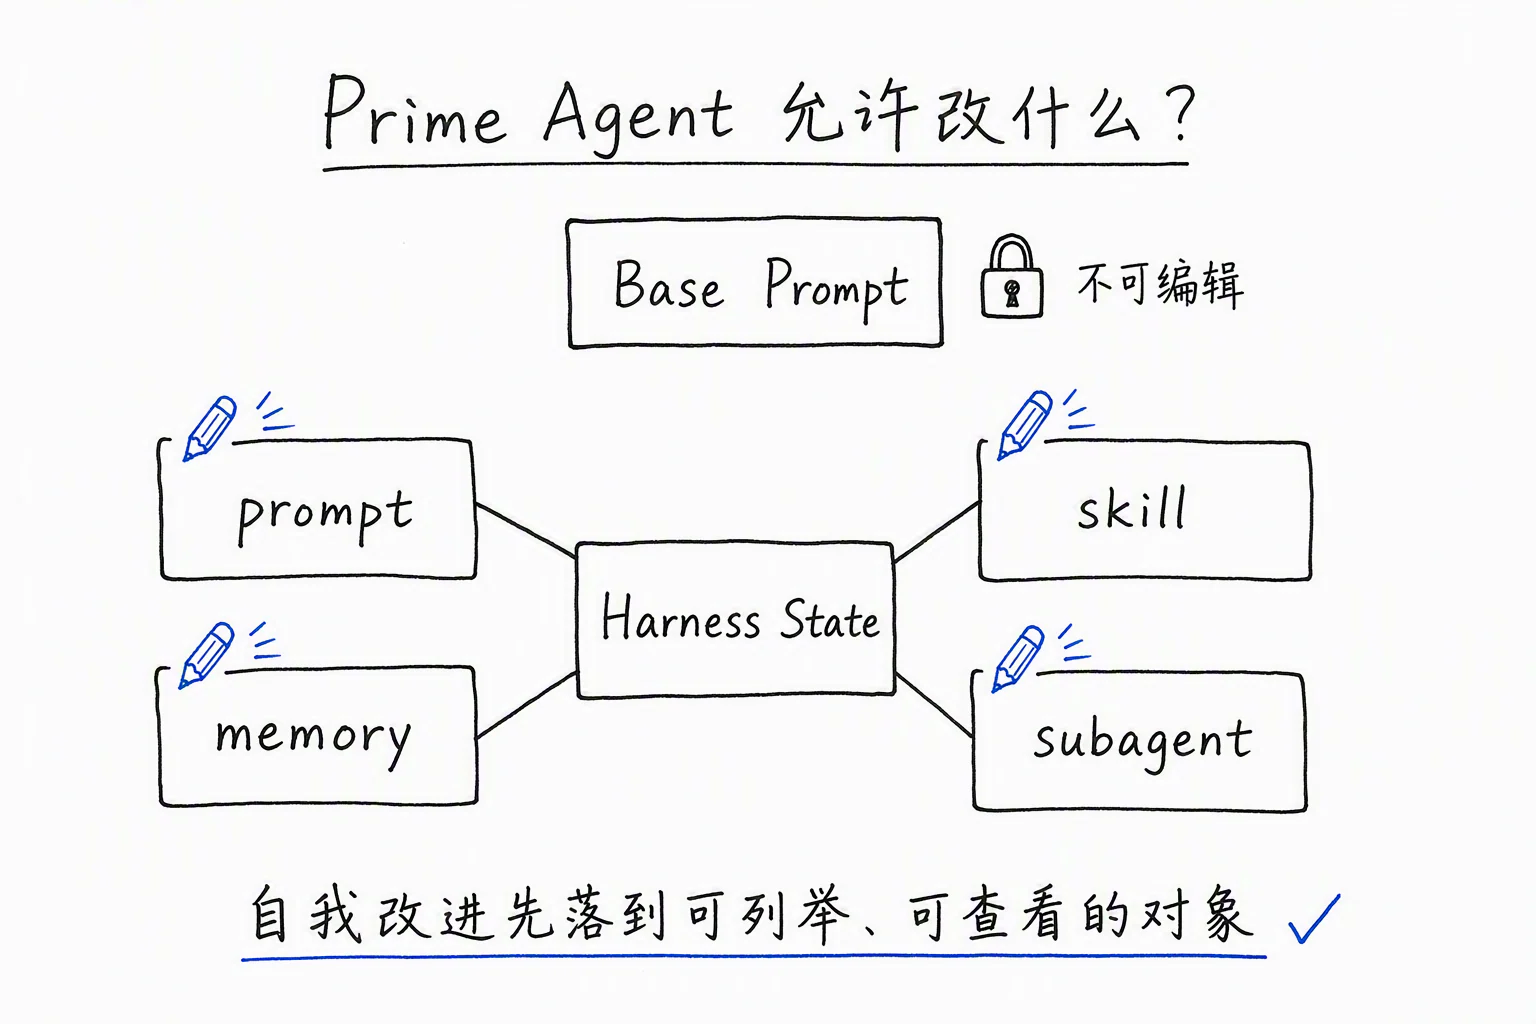
四种状态有明确分工。Prompt 保存窄范围的行为附注;memory 保存事实、决定、失败、偏好和结果;skill 描述可重复执行的 Python 流程;subagent 保存可复用的委派角色。Refiner 的系统提示还规定,重复流程才进入 skill,稳定事实才进入 memory,重复委派模式才进入 subagent。经验要先被分类,系统才知道下一轮怎样调用它。
这里的 skill 也不是一句自然语言说明。创建或更新 skill 条目时,校验器要求提供 Python reference、import、callable 或 call pattern,以及参数契约。/refine 能登记一项已经存在的可执行能力,却不能凭一段描述替代 Python package 的生成、测试和审查。
一次手动 /refine 会读取最近 80000 个字符的轨迹、当前 Harness 概览、历史 refinement 和作用域规则,再让模型返回 create、update、delete 三种 JSON 编辑。Refiner 被要求只做 small, evidence-backed edits。没有足够证据时,它应该返回空编辑,而不是为了表现“学到了”强行写一条规则。
Prime Agent 还会自动寻找学习时机。默认设置是每 25 个 assistant turn 或每次 context compaction 后触发一次 review,两个 review 至少间隔 20 分钟。Review gate 先用最近 40000 个字符判断轨迹里有没有值得保留的证据,通过以后才运行完整 /refine。自动更新只允许发生在有持久 session 的 root Agent 上,递归子 Agent 不能各自无限改写全局状态。
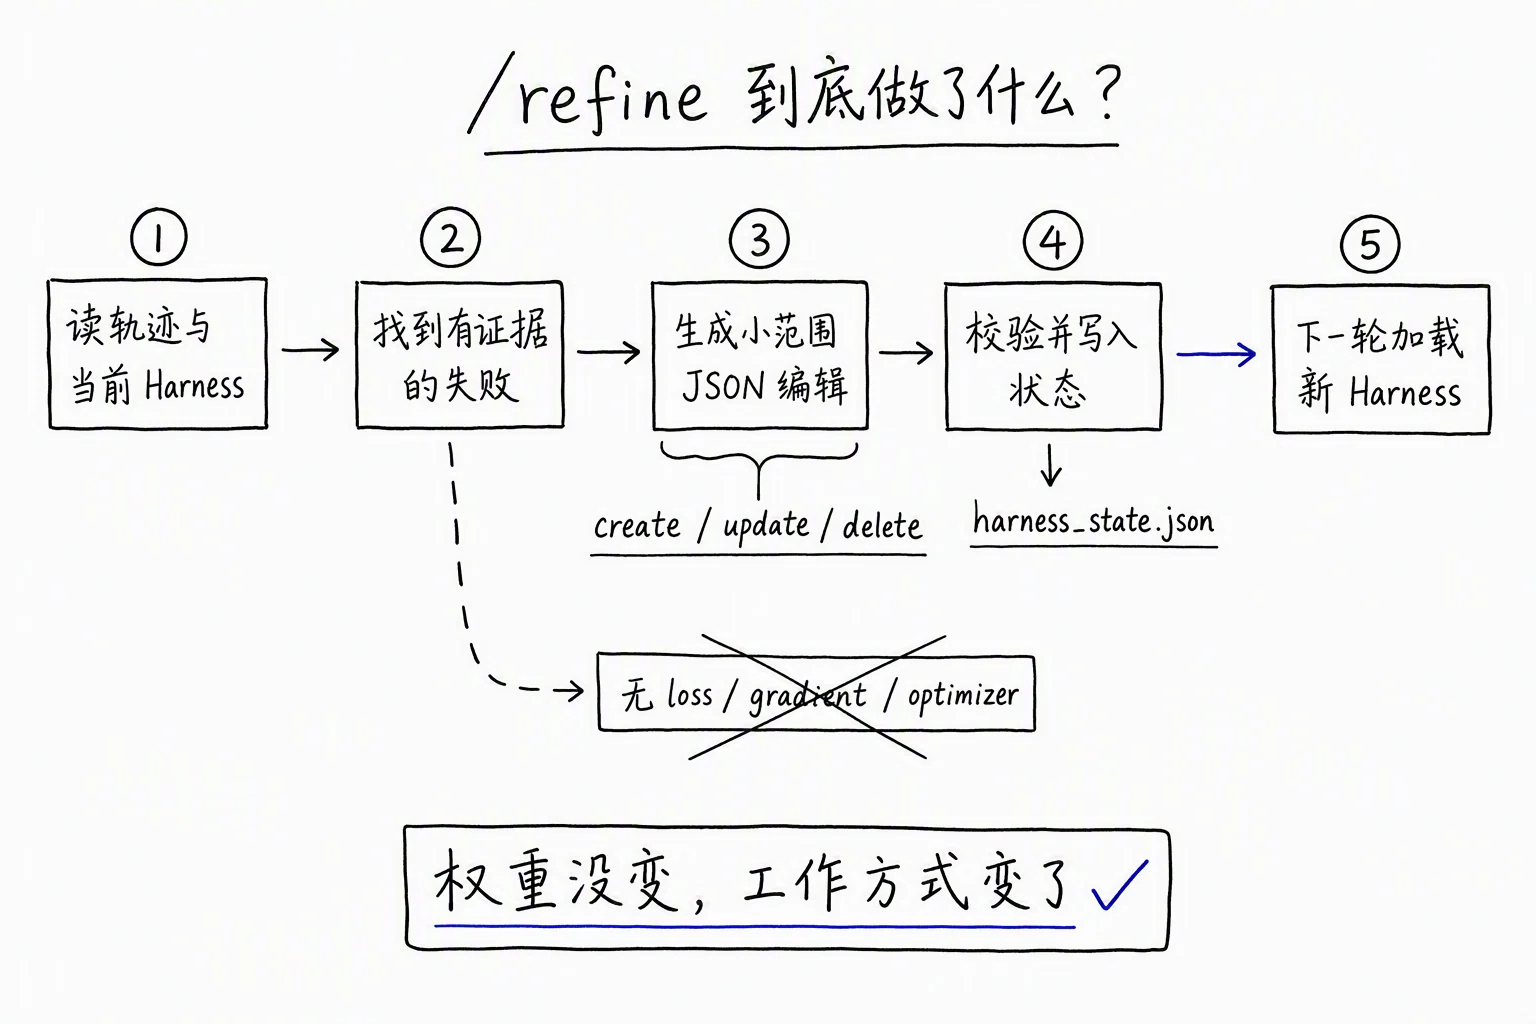
/refine 把执行轨迹变成小范围 Harness 编辑,写入持久状态,再由下一轮 Agent 加载。规划和应用也被拆成两个阶段。LLM 规划可能持续几十秒,这期间 kernel 或另一个 session 仍可能修改 harness_state.json。Prime Agent 会在写盘前重新读取目标状态,把它与规划开始时的 baseline 比较。条目已经变化,这项编辑就以 entry changed during refinement planning 被拒绝。一次旧计划不会静默覆盖新状态。
通过校验的修改不会在 Agent 正执行一半时插进 system prompt。系统等到安全的 turn 边界,短暂断开当前 Agent,完成 apply、save 和 reconnect。状态文件先写入临时文件,再通过 rename 原子替换;新文件默认权限是 0600。
持久化分成 local 与 global。Local Harness 跟着当前 session artifact 保存在它自己的 harness/ 目录,适合任务进度、临时阻塞和当前仓库事实。Global Harness 写入 ~/.prime/agent/harness/harness_state.json,跨会话修改另外追加到 refinements.jsonl。构建下一轮 prompt 时,系统同时读取两份状态;同名冲突不会静默覆盖,local 条目会带上 local: 前缀与 global 条目一起进入概览。
Prime Agent 的价值主要来自限制。代码会拒绝任何针对 base_system_prompt 的编辑。每条 refinement 记录 trigger、changes、evidence 和 expected outcome,每项 edit 保存 before、after 和版本。/refine rollback <id> 会倒序读取这些快照,恢复旧条目或删除当时新建的条目。
Autonomous mode 又把“继续尝试”和“任务成功”分开。默认预算只有三次 continuation、十二个 turn、八万 token 和三十分钟。用户可以配置 shell command 作为 quality gate。Gate 失败以后,Agent 会继续修;工作区没有变化时,同一条失败 gate 不会被原样重跑。Gate 通过只会返回 not_needed,表示不必继续;预算耗尽返回 limit_reached,也不代表任务完成。
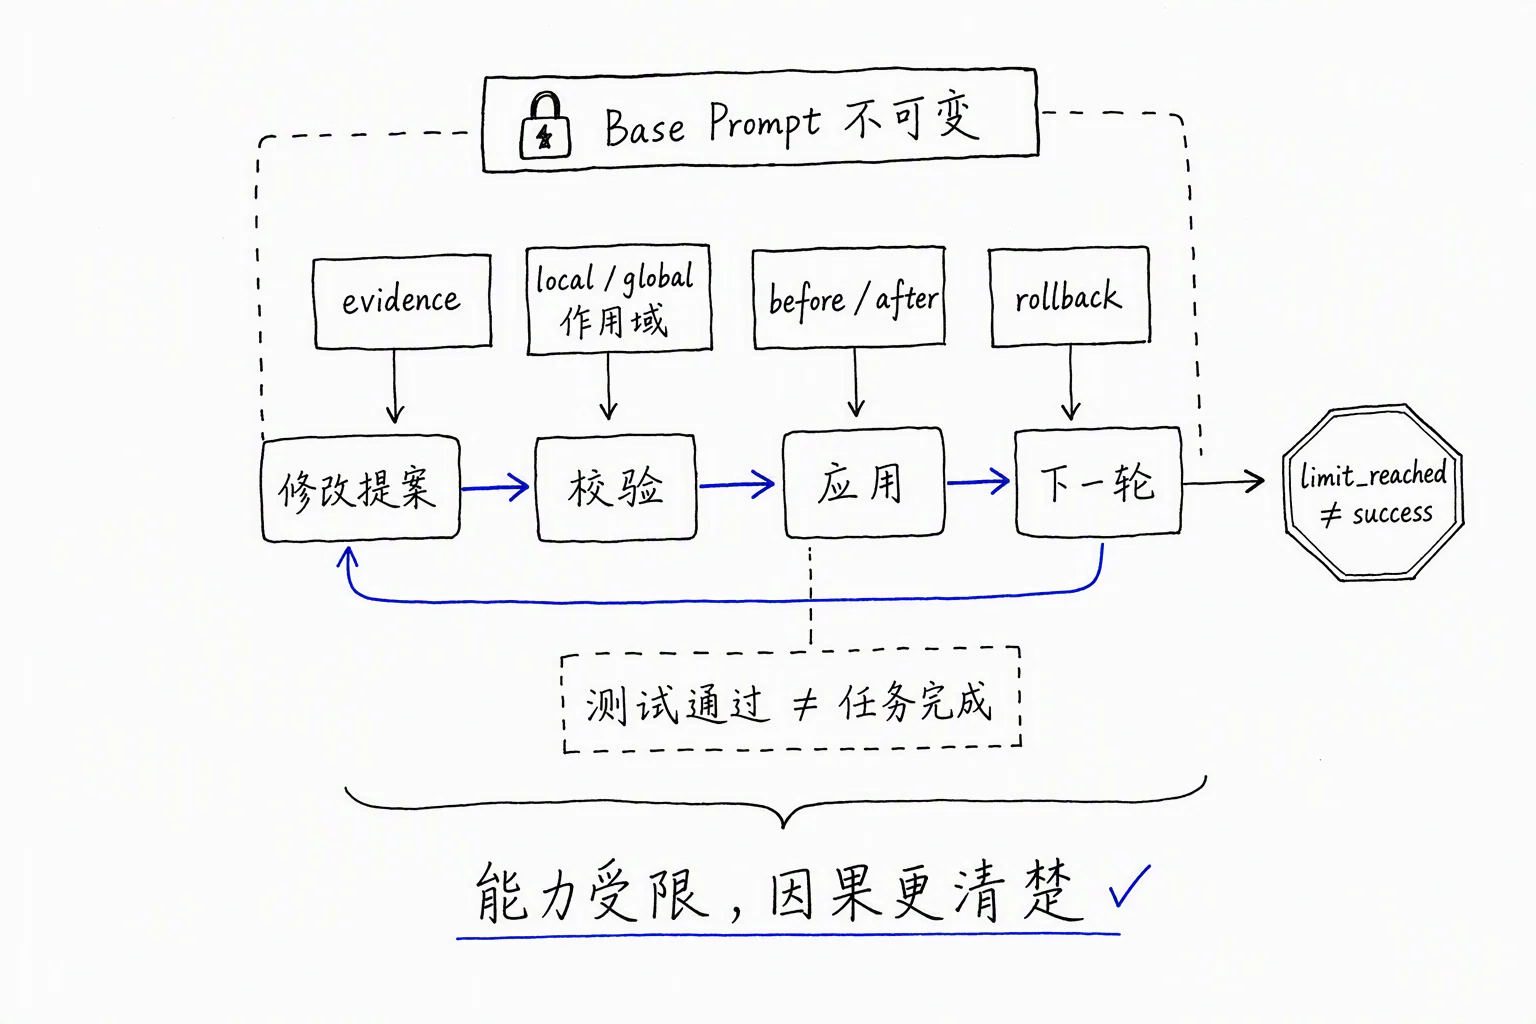
Continual Harness 论文还有一个外层循环。它会让更强教师重标执行轨迹,再更新模型权重。Prime Agent 仓库没有把这部分塞进运行时,而是把 PRIME-RL 和 Verifiers 作为独立项目连接出去。高频、容易撤销的经验先留在 Harness;低频、代价更高的权重更新走另一条管线。
Prime Agent 因此没有证明模型会训练下一代自己。它证明了另一件更具体的事。Agent 可以从自己的轨迹里产生持久修改,下一轮真的加载这些修改,同时仍保留不可变核心、作用域、并发检查、审计记录和撤销路径。
它也没有自动证明每次 refinement 都提高了任务能力。expectedOutcome 是修改者写下的预期,不是实验结果;autonomous quality gate 检查当前工作区是否满足用户配置的命令,也没有默认对新旧 Harness 做 A/B 测试。Prime Agent 做得最好的是更新协议和状态治理,收益验证仍要接到外部 benchmark。
把三个案例放在同一条轴上,差异来自可修改空间的大小。
Prime Agent 只开放四类 supplemental state,搜索空间小,改动容易归因。MiniMax 允许 optimizer 同时搜索采样参数、工作流和 scaffold code,范围更宽,可以处理更多失败,也需要更多评测预算。DeepSeek 进一步把 runtime 变成开放插件图,新 plugin 甚至能创造下一轮才出现的工具,能力上限最高,权限和归因也最难控制。
可修改空间扩大以后,系统更容易找到有效办法,也更容易改到评分漏洞、偶然相关和安全边界。三家最终都会撞到同一个问题,谁来判断这次修改应该留下。
一条经验怎样进入下一次任务
MiniMax、DeepSeek 和 Prime Agent 给出了三种自修改接口。一次修改要变成可复用经验,还要经过归因、写入、治理、调用和验证。
MiniMax 能让搜索持续一百多轮,公开材料没有说明系统怎样判断某次失败来自 prompt、采样参数还是 runtime。DeepSeek 能让 Agent 写出新 plugin,diagnostics 与 mount validation 只能证明代码能运行。Prime Agent 能把修改写进四类持久状态,expectedOutcome 仍是 refiner 的预期。
三个案例停下来的位置,正是经验开始变难的地方。系统需要从轨迹里找对原因,把修改放到合适载体,再证明目标 Agent 会在新任务里使用它。
Self-Harness 从失败里提出修改
Self-Harness 把失败归因与候选晋级做成了一个受控实验。固定模型先执行任务,留下带 verifier 结果的轨迹。系统聚类失败,找出某个模型反复出现的弱点;同一个模型再提出少量、范围明确的 Harness 修改。每项修改都要经过回归测试,达到接受条件才进入下一版。
三个模型得到的 Harness 并不相同。
MiniMax M2.5 经常太晚创建交付文件,也会陷进很长的工具循环,修改因此强调尽早落盘和及时止损。Qwen3.5-35B-A3B 更需要提前检查依赖、避免重复失败命令,并在工具报错后仍然完成要求的产物。GLM-5 的问题集中在跨 Shell 命令保持环境设置,以及更快从探索转到实现和测试。
最新版实验覆盖 Terminal-Bench 2.0、SWE-bench Verified 和 AppWorld,三个模型与三个 benchmark 组成的九个组合都得到提升。只看 Terminal-Bench 的 held-out split,MiniMax M2.5 的 pass rate 从 40.5% 升到 61.9%,Qwen3.5-35B-A3B 从 23.8% 升到 38.1%,GLM-5 从 42.9% 升到 57.1%。
Self-Harness 的价值不只在涨分。它说明同一份通用“最佳实践”并不适合所有模型。Harness 要对准目标模型实际会犯的错。
Self-Harness 先把最容易混淆的两步分开。失败轨迹用于找问题,候选 Harness 用另外的任务检查。沿着这个动作继续拆,一条经验至少要过五道门。
- 归因。系统要找到造成失败的原因。网络超时不能被写成推理策略错误,测试脚本损坏也不能归咎于模型不会写代码。
- 抽象。规则要覆盖同类任务,又不能宽到干扰无关场景。“所有命令失败后都换方案”就可能跳过本应重试的瞬时故障。
- 写入。经验要进入正确组件和作用域。仓库路径属于 project memory,重复工作流适合 skill,硬约束更适合代码和 permission gate。
- 触发。后续任务要在正确时机检索并加载它。存档里有一条好规则,Agent 没找到,效果仍然是零。
- 验证。候选要在没有参与提炼的任务上继续有效。只修好了产生这条规则的几个 case,更像补丁,不像学习。
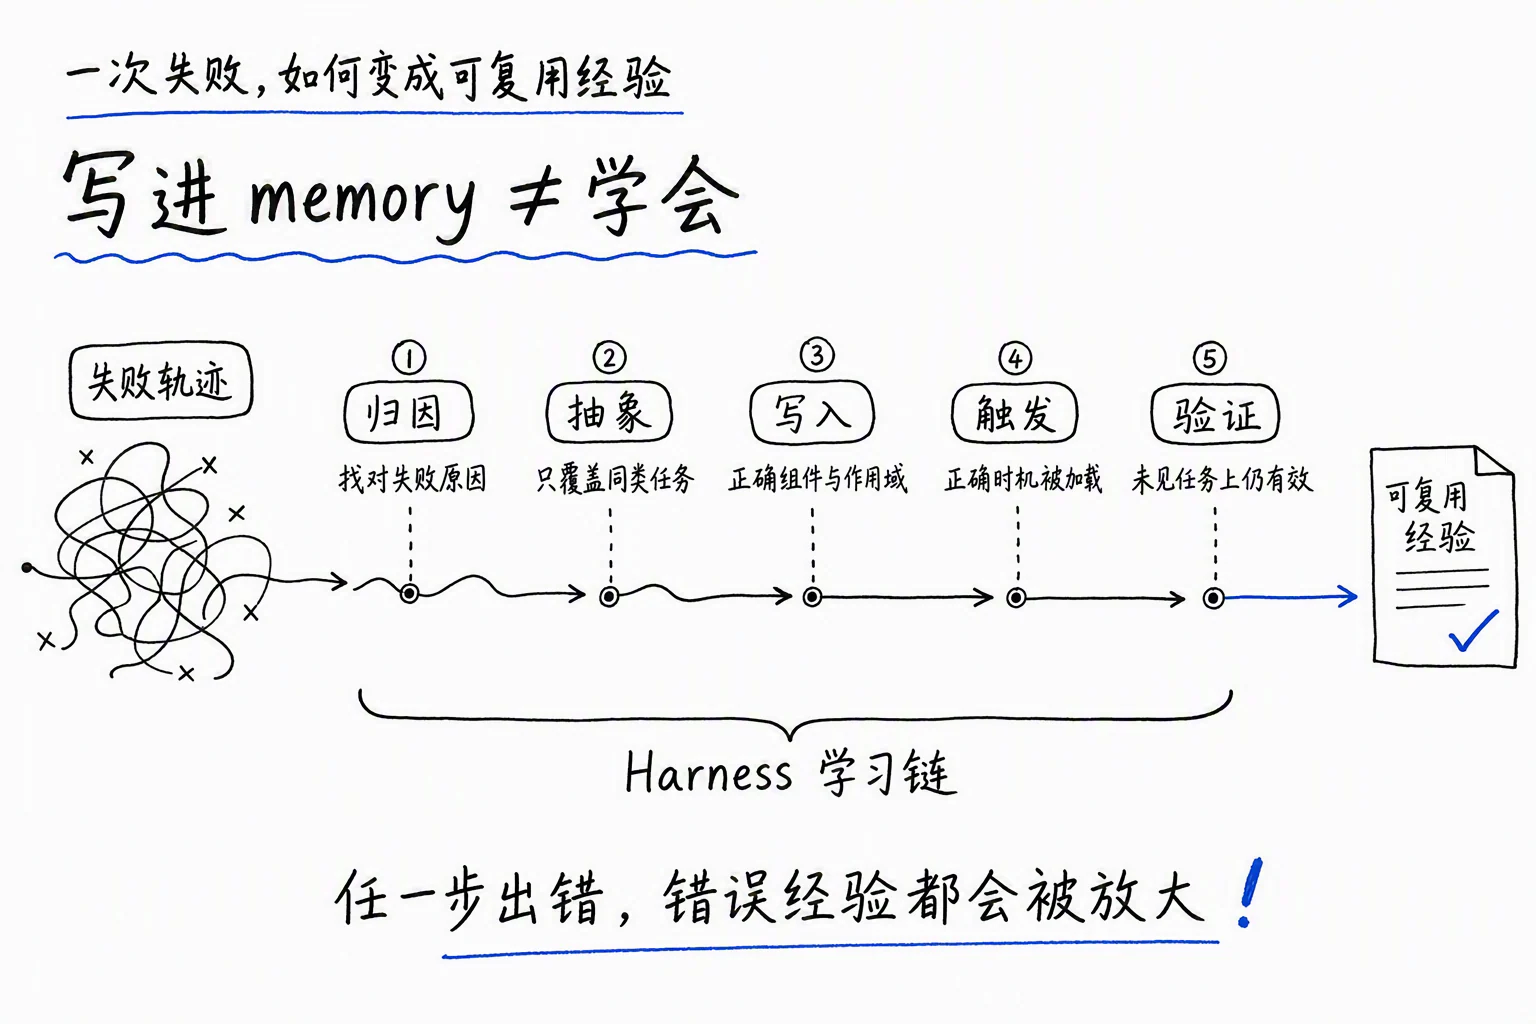
Self-Harness 的 held-in 轨迹负责找失败和写候选。Held-out 轨迹不向 proposer 暴露,但 split 上的分数会参与每轮候选晋级。它能挡住针对已知轨迹的直接修补,仍然属于反复使用的 validation gate,不是最终只打开一次的 hidden test。搜索轮数增加以后,optimizer 仍可能逐渐适应这道门。
把这套方法放回三个工程案例,缺的步骤就清楚了。MiniMax 的循环检测要能对应一组重复卡死的轨迹;DeepSeek 的动态 plugin 要先在回归任务上胜出,才有资格写进持久 preset;Prime Agent 的 rationale 和 expected outcome 要继续接到新任务的实际结果。写进 memory,只证明文件变了。
SkillOpt 与 Hermes 管理外部经验
Harness 状态可读,不代表它可以随便改。
一项准备上线的更新,至少要留下修改对象、证据、作用域、before/after、版本和回滚办法。再记一项 outcome,系统才能知道这条规则后来帮过什么。半年以后看到一句“遇到失败先重试”,也能查出它来自哪个故障、服务哪类任务、是否已被新工具淘汰。
SkillOpt 把一份 skill 文档当成 frozen agent 的外部参数。目标模型跑任务,独立 optimizer 从成功和失败轨迹里提出 add、delete、replace 编辑。每次能改多少由文本学习率限制,被拒绝的编辑会进入负反馈缓冲区,候选只有在 held-out selection split 上严格提高才被接受。
这套约束有点像权重训练。Rollout batch 决定这次更新看到了多少证据,编辑预算控制步长,validation gate 决定是否提交,slow/meta update 保存跨 epoch 稳定的方向。最后部署的仍是一份大约 300 到 2000 token 的 best_skill.md,不会增加推理时的模型调用。
论文在六个 benchmark、七个目标模型和三种执行环境上测试了 52 个组合。SkillOpt 在全部组合里最好或并列最好。以 GPT-5.5 为例,相对没有 skill 的基线,direct chat 平均提高 23.5 个百分点,Codex Agent Loop 提高 24.8 个百分点,Claude Code 提高 19.1 个百分点。
这里更重要的结果是迁移。一份在 Codex 环境里优化的 spreadsheet skill,换到 Claude Code 仍然有收益;面向一个模型规模训练的 skill,也能帮助同系列较小模型。外部状态因此可以像软件包一样训练一次、检查内容,再部署到相近环境。
长期运行还需要处理失效。
当前版本的 Hermes Agent 默认累计十次工具迭代后触发一次 skill review。触发只是让模型检查近期任务里有没有值得保存的流程,并不保证每十轮自动生成一个 skill。Skill 进入库后还有 active、stale 和 archived 三种状态;默认 30 天无活动转为 stale,90 天进入可恢复的 archive,再次使用又会激活。
这几项状态没有自动生成 skill 那么显眼,却决定技能库半年以后还能不能用。系统只会新增,不会合并、降级和归档,skill 越多,检索越难,冲突越多,每次推理都要为旧经验付上下文成本。
Prime Agent 已经有 local、global、version 和 rollback,缺少的是类似 Hermes 的过期与归档。DeepSeek 把动态 Package 和持久 preset 分开,仍需要一条从试验态晋升到长期状态的证据规则。MiniMax 连续搜索一百轮以后,也要知道旧 workflow 何时已被新模型和新工具淘汰。
Harness 的显式性让维护对象变得可查,也把维护责任留在了系统里。
写出规则以后,目标 Agent 还要会用
Harness 主要是文本和代码,模型能力却不会同等作用于写规则和用规则。
《Harness Updating Is Not Harness Benefit》把这两个问题拆开了。
harness-updating 看 evolver 能不能从执行证据里写出有用更新。harness-benefit 看目标 Agent 能不能在后续任务里找到、加载并遵循这些更新。前者负责写手册,后者负责拿到手册并照着完成长任务。
实验结果没有随模型能力单调变化。
当目标 Agent 固定时,不同档位 evolver 写出的 Harness 收益很接近。Qwen3.5-9B 产生的更新可以接近 Claude Opus 4.6;任一 benchmark 上,evolver 之间的更新收益差距最多只有 3.1 个百分点。昂贵模型不一定更会把失败写成规则。
差距主要来自使用者。
弱模型有最大的提升空间,实际收益却很低。Qwen3-32B 的 skill load rate 只有约 25%,强模型接近 96%。Skill 已经加载以后,Qwen3-32B 的 Harness-Following Rate 是 0.142,Opus 4.6 是 0.757。弱模型先卡在 activation failure,随后又卡在 adherence failure。
强模型位于另一端。它们能加载也能执行,但原始能力已经接近任务上限,剩余空间较小。中间档模型既有提升空间,又有足够能力使用复杂 Harness,收益反而最大。
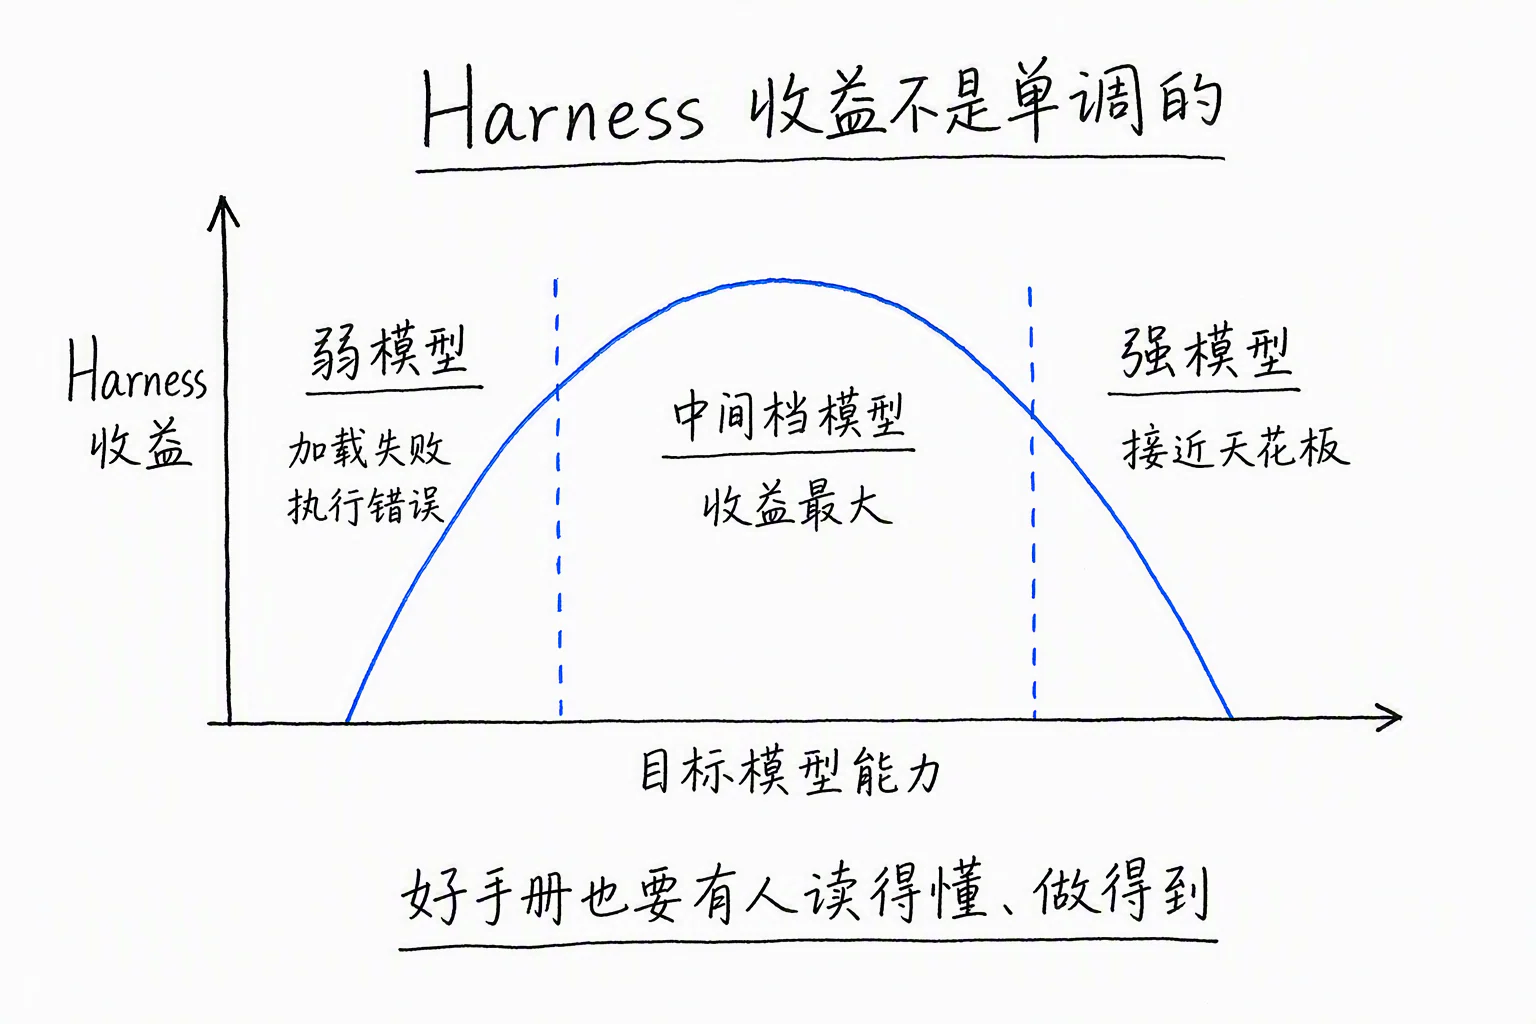
这组结果改变了工程预算的分配。离线读轨迹、写候选规则,可以交给较便宜的 evolver;执行任务的模型需要承担检索、工具调用、长程遵循和错误恢复,能力预算更应该留在这里。
这个问题在三个案例里会呈现为不同故障。MiniMax 写进 workflow 的跨文件检查可能被目标模型跳过;Prime Agent 已经加载 skill 条目,模型却可能没有按 reference 调用 Python;DeepSeek plugin 已经注册新工具,模型也可能从未选择它。这些故障都落在 Harness benefit 一侧。更新已经存在,目标 Agent 没有把它转成实际动作和结果。
一本好手册也要有人拿得到、读得懂、做得到。
谁来判断 Harness 真的变好了
规则被正确写入、加载和执行以后,最后还要证明分数来自这条规则。三条工程路线都没有独自完成这件事。
MiniMax 的内部 evaluator 决定 100 多轮里哪些 scaffold 修改留下,但公开材料不足以检查任务切分和搜索预算。DeepSeek 的 diagnostics 与 mount validation 检查 plugin 能否运行,没有回答目标任务是否变好。Prime Agent 的 quality gate 能验证一组用户指定的命令,也不会自动比较新旧 Harness 的因果差异。
三者的共同缺口来自同一种权力关系。生成修改和裁决修改属于两种权力。前者需要看到足够多的轨迹并大胆搜索,后者需要保持稳定,不能随着候选一起被改写。
Recursive Harness Self-Improvement 用当前 Harness 做任务,再把新旧版本做成对比较,优化 prompt 级的 Agent loop。论文在 30 个合成机器学习研究任务上报告,少量迭代后,低推理档位配合优化 Harness 可以超过高推理档位,推理成本最多下降 60%。
RHI 省预算的办法很直接。理想搜索需要让一批 Harness 两两对比,候选数量为 时,评估成本接近 。RHI 每轮只让新候选与上一版 incumbent 比一次,单步评估成本降到常数级。修改者还能看到之前版本、输出和成对反馈,继续沿着胜出的方向修订。
代价是路径依赖。一次误判可能让后续搜索沿着较差版本继续走,局部胜出也不保证它在整个候选集合里最好。Pairwise evaluator 的稳定性因此直接决定这条进化轨迹会走到哪里。
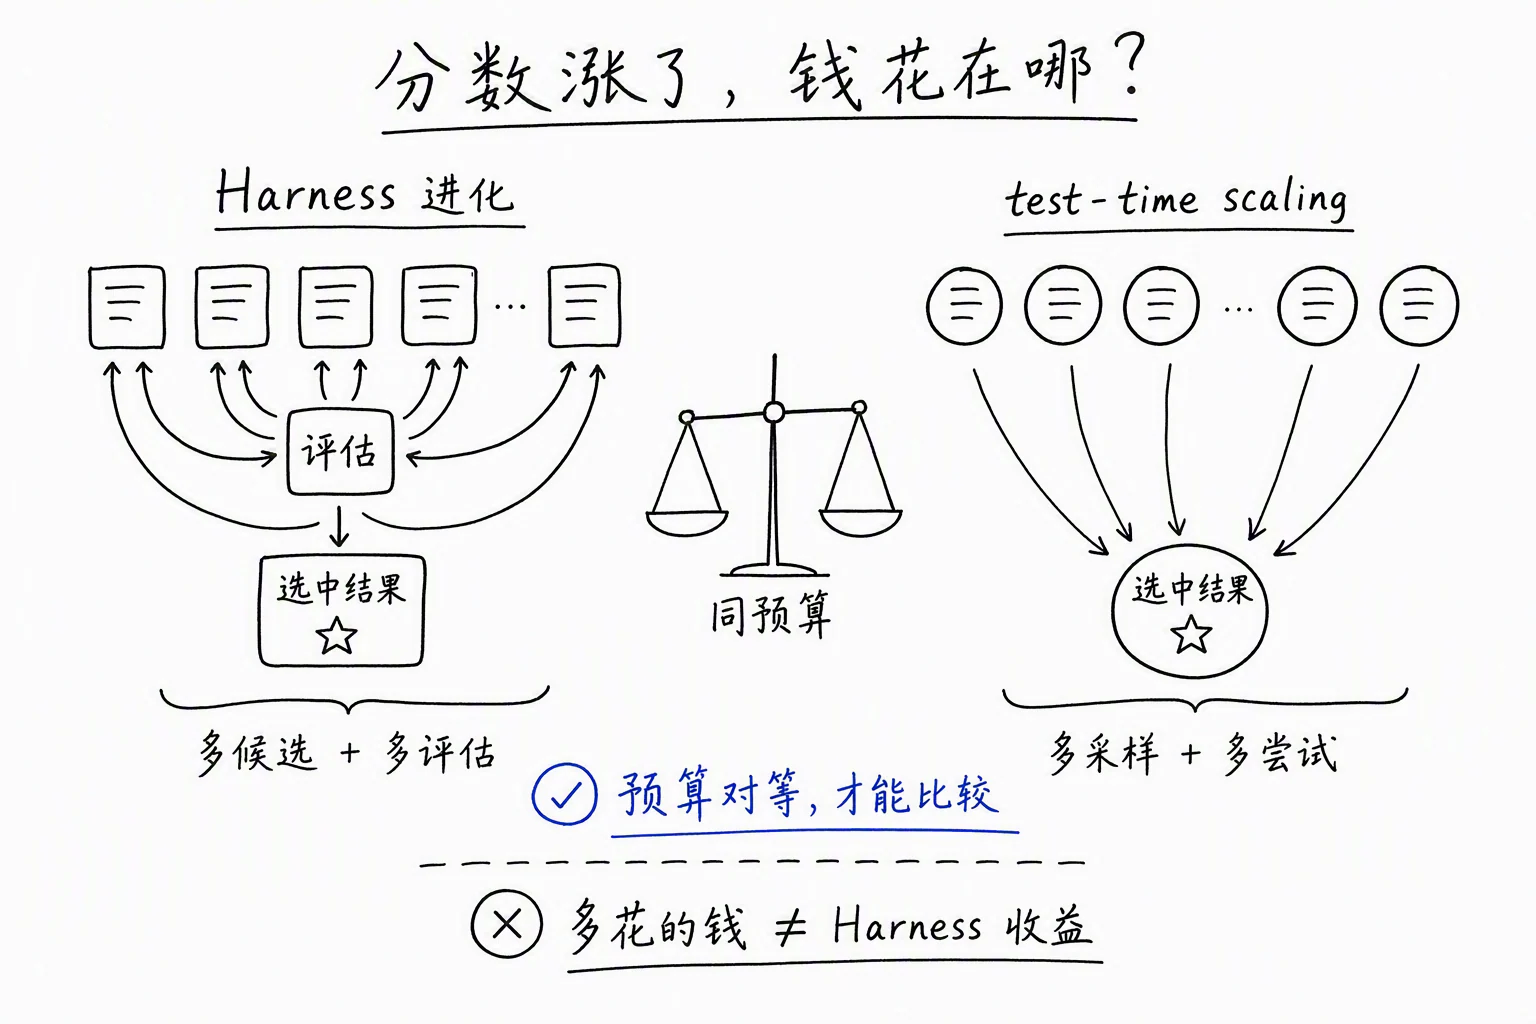
Harness evolution 会生成多个候选,反复评估,再选择较好的版本。简单的 test-time scaling 也会多采样、多尝试,再选一个较好的结果。前者花十份预算,后者只跑一次,最后把全部差距归给 Harness,结论站不住。
Ai2 与华盛顿大学的对照实验把预算问题摆到了台面上。他们在 Terminal-Bench 2.1 上比较 Harness evolution、并行采样和顺序修订,控制各方法能看到的反馈与推理预算。自动 Harness evolution 没有稳定超过简单的 test-time scaling,换到 held-out 任务以后,泛化也很有限。
另一种混淆来自数据。用同一批 benchmark case 搜索 Harness,又在同一批 case 上汇报结果,优化器会逐渐适应这些题的共同结构。规则写得很通用,作用可能只停在搜索集。
Weco 的 AIDE² 实验为这种证明提供了更严格的做法。外层 Agent 连续运行八天,用 100 步改写内层 autoresearch Agent,约九成候选被拒绝。每个任务都有 public score 和不可见的 private score,所有候选使用固定成本预算,训练任务还故意横跨机器学习工程、启发式算法和 Harness 工程。
最终留下的 AIDE47 和 AIDE85 又去了三个搜索期间从未见过的外部 benchmark。两者都超过起点 AIDE0。AIDE85 在 held-out GPU kernel 任务上的 reward hacking 比例也从 AIDE0 的 63% 降到 34%。
这仍是项目方自行设计和发布的实验,不能当成 RSI 已经解决。它至少把固定物理预算、不可见私有分数、异质任务和分布外复测同时放进了协议。
Self-Harness 的回归门和 AIDE² 的 private score 都会参与搜索中的候选选择。它们比同集搜索可靠,仍可能被多轮选择逐渐适应。最终测试需要继续留在搜索之外。
HarnessOpt-Bench把这条边界做成了公共评测协议。
Optimizer 拿到 seed Harness、开发阶段反馈和固定的 target-evaluation budget。它可以编辑代码、请求评估、保留多个候选,最后只能提名一个版本。这个版本才会进入从未暴露的 hidden test。
论文用归一化增益衡量候选吃掉了多少剩余提升空间。
是 seed, 是最终提名版本。 表示优化一轮以后还不如起点。分母用 seed 剩余的 headroom 做归一化,让不同起点的任务可以放到同一尺度上比较。
协议最硬的部分不在公式里。
Development 会给逐案例结果和轨迹,validation 只给聚合分,test 在提名前完全不可见。Optimizer 只能写 Harness,不能改任务数据和评分结果。所有模型调用经过 Gateway,模型 allow-list 和每个作用域的预算由外部系统计量。候选在隔离沙箱里运行,每个版本都留档。
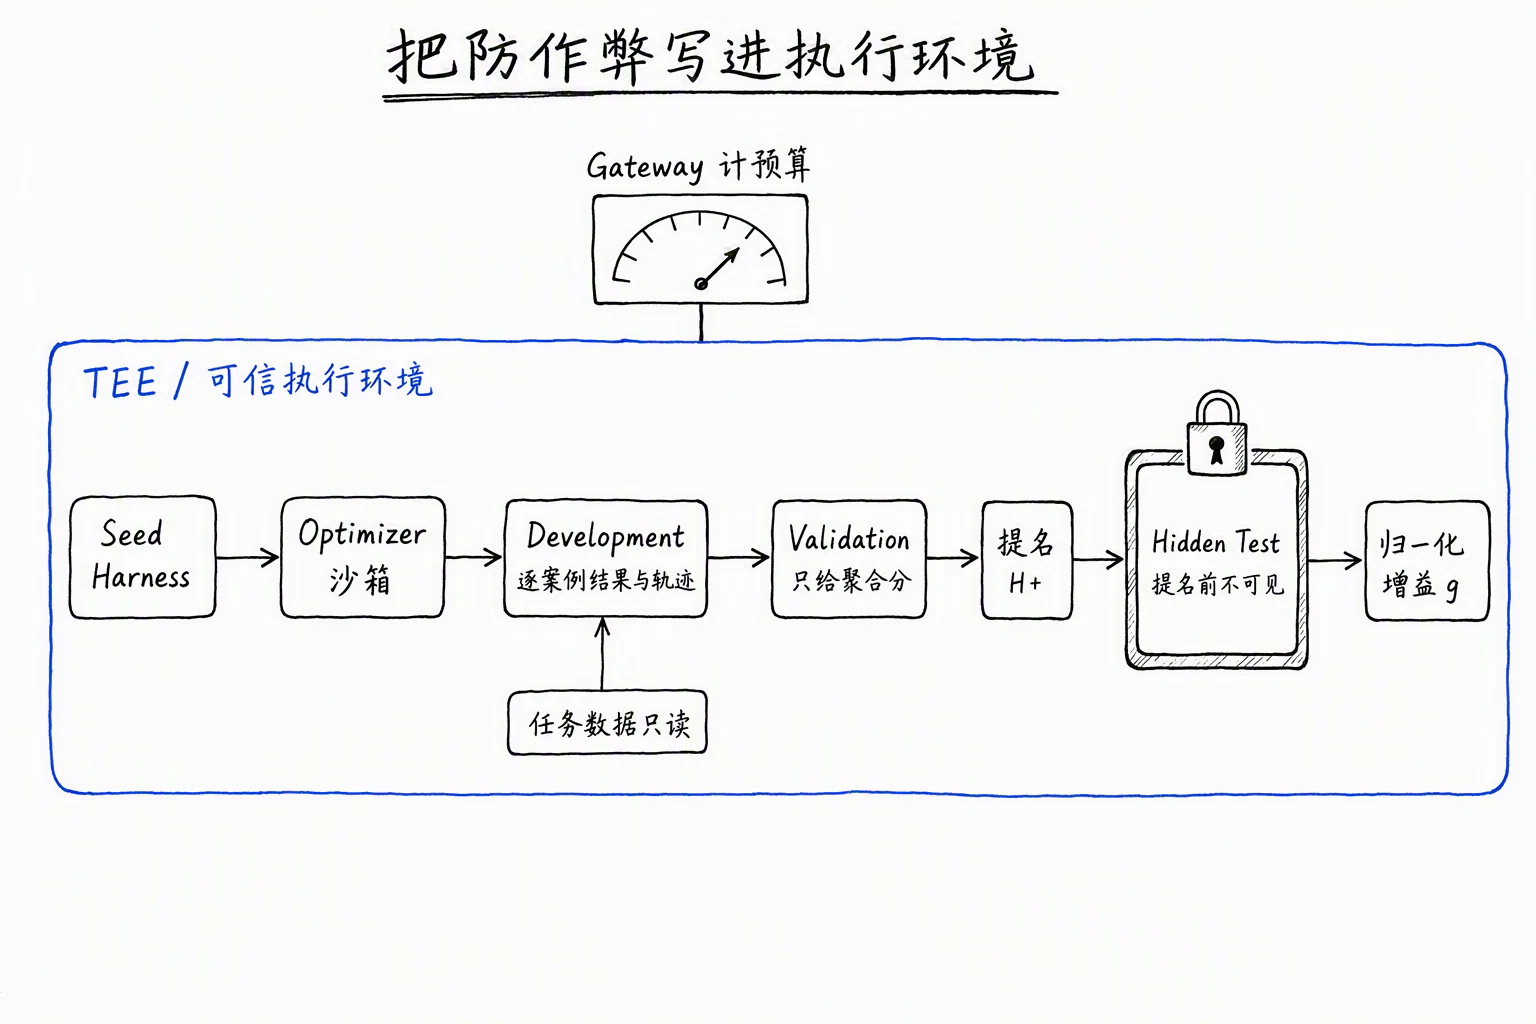
这些边界没有写进 prompt 里劝模型遵守。Hidden test、凭证和预算控制根本不在 optimizer 的沙箱中。防泄漏是执行环境的属性。
HarnessOpt-Bench 在四项任务上测试五个 frontier optimizer,完成 111 次评分运行。结果里有三个信号很重要。
第一,optimizer 模型之间的差距,平均大于 shared 与 native coding harness 之间的差距。谁来优化,比它通过哪套 coding 工具动手更重要。
第二,native harness 没有稳定占优。模型熟悉自家工具链,并不自动等于更会改目标 Agent。
第三,搜索范围更广通常伴随更高 held-out gain,仔细阅读失败轨迹却很少发生,也没有表现出正相关。当前 optimizer 更像会扩大搜索的工程师,还没有稳定学会从失败里做因果归因。
这恰好回到 Harness 学习链的第一道门。
做 Harness RSI,应该把什么留在循环之外
MiniMax、DeepSeek 和 Prime Agent 各自解决了 Harness RSI 的一部分。MiniMax 让搜索循环长期运行,DeepSeek 扩大了系统可以修改的对象,Prime Agent 把持久更新限制在可审计状态里。
把三条路线拼起来,一套可维护的实现需要同时容纳探索能力、状态治理和独立判断。工程上可以先守住七条原则。
- 把判断放在尝试之外。 MiniMax 的内部 evaluator、Prime Agent 的 quality gate 和 DeepSeek 的 diagnostics 都可以提供开发信号,最终 verifier、hidden test、预算计量和访问凭证应由 optimizer 无法修改的外部系统掌握。
- 先冻结一块不可变核心。 Prime Agent 禁止修改 base system prompt,DeepSeek Harness 保护系统 preset 和 host-side permission,MiniMax 的 evaluator 也应独立于 scaffold 搜索。系统需要一块稳定参照,才能解释行为变化来自哪项编辑。
- 每次只改少量状态。 Prime Agent 的 evidence、before/after、version 和 rollback 是最低配置。MiniMax 那类跨采样参数、workflow 与 runtime code 的搜索,还要记录每项修改的消融结果。
- 经验按作用域逐级晋升。 Prime Agent 的 local/global 和 DeepSeek 的 dynamic Package/persistent preset 都在区分试验态与长期状态。新经验先留在 session,跨任务成立以后再扩大影响范围;过期规则还要能降级和归档。
- 分别评估写规则和用规则。 Evolver 能写出好 Harness,不代表目标 Agent 会加载和遵循。Activation rate、adherence 和最终任务结果要分开看。
- 用同预算搜索做对照。 Harness evolution 与 test-time scaling 都会从更多尝试中获益。模型调用、环境运行、失败候选和 wall clock 都应计入同一预算。
- 最终 test 只打开一次。 Development 用来找失败,validation 用来选候选,hidden test 只在最终提名后评估。反复参与晋级的 held-out split 已经是 validation。
这套系统可以画成内外两个循环。
内层尝试
生成修改 → 执行任务 → 保存轨迹

外层判断
固定预算 → 独立评估 → 接受或回滚
内层可以大胆搜索,外层必须稳定。把两层交给同一个可修改对象,系统迟早会找到让分数更好看、却没有让任务变好的办法。
这些条件凑齐以后,系统得到的是 train-free self-improvement。模型权重没有变化,下一轮 Agent 却因为持久 Harness 状态而换了工作方式。严格 RSI 还要继续证明更新方法本身也在变强,不能只让同一套 optimizer 多跑几轮。
可以拿 MiniMax 留下的“修复后搜索其他文件里的同类 bug”走完一次验收。搜索循环先从多次漏修中发现它;Prime Agent 式状态管理把它写成带 evidence、作用域和版本的 prompt 或 skill;需要强制执行时,DeepSeek 式 plugin 可以把跨文件搜索放进运行时 hook。外部 evaluator 再用相同预算,把新旧 Harness 放到未见仓库里比较。
只有新规则在那个仓库里被正确加载、真的执行,并减少同类漏修,它才是一条学会的 Harness 经验。