RSI 综述 2|Artifact 层,当 Agent 开始自动做研究
Artifact 层最早跑出规模化的自我改进,因为代码、算法和训练配置可以执行、比较和筛选。它把一部分研究变成有状态的搜索,搜索空间决定系统能改什么,verifier 决定什么会被留下;产物可以持续进步,研究 Agent 却未必因此获得可复用能力。
Karpathy 的 autoresearch 仓库很小,承载实验规则的只有三个文件。
prepare.py 管数据、tokenizer 和评估,不让 Agent 改。train.py 装着模型、优化器和训练循环,Agent 可以随便动。program.md 写研究规则,由人维护。
每次实验固定训练五分钟,只看 val_bpb 一个数,越低越好。Agent 改完 train.py,提交代码,启动训练,读出结果。分数变好就沿着这个版本继续,变差就回退。按默认节奏,一小时约 12 次,一夜接近 100 次。
仓库展示的第一次运行里,83 次实验留下 15 次改进。大量灰点没有用,结果沿着一条缓慢下降的绿色阶梯往前走。
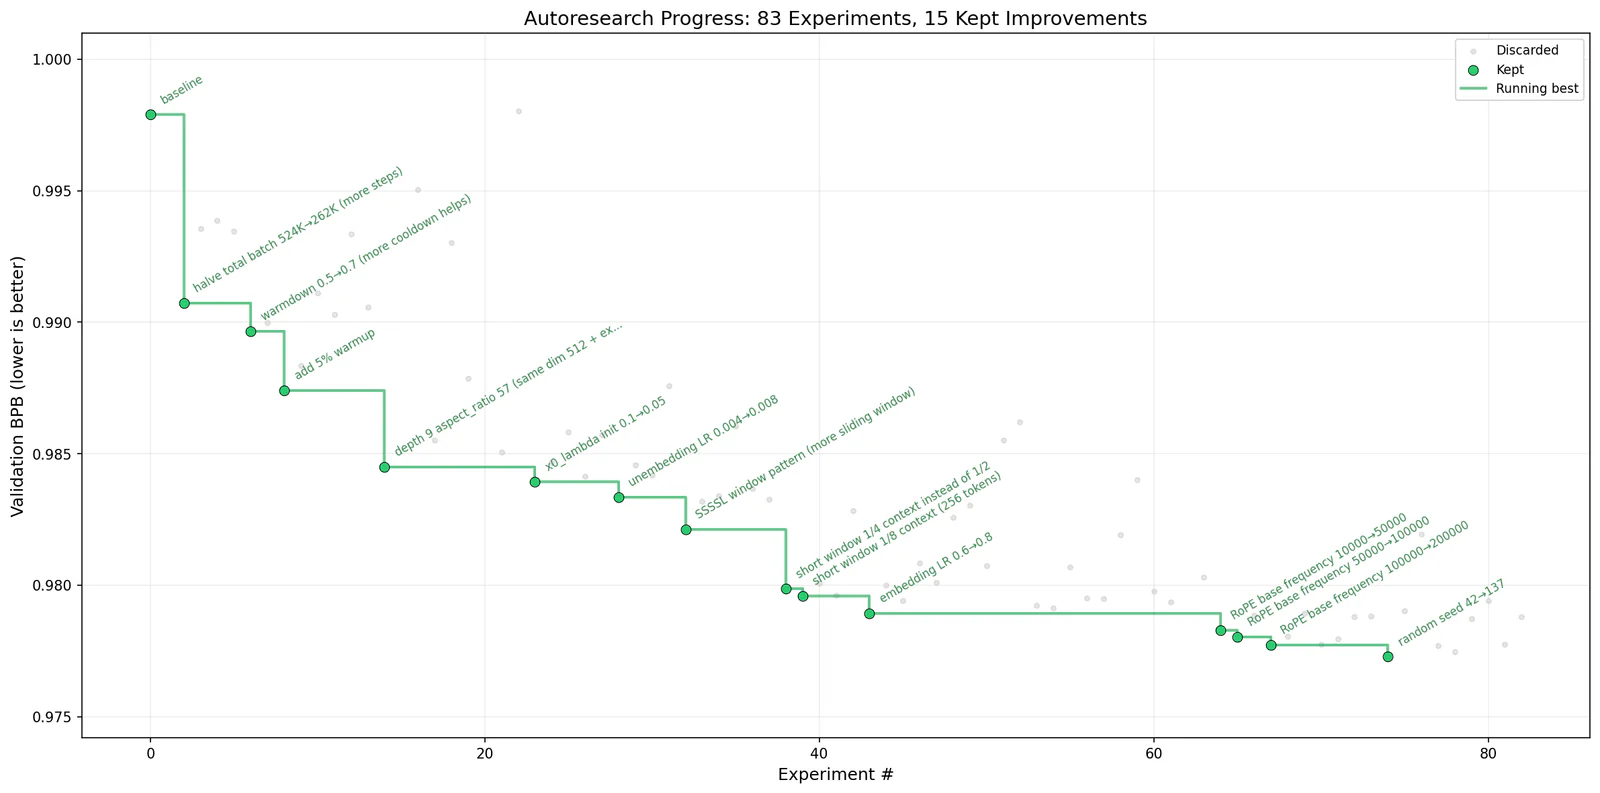
这张图很像研究,又少了研究里许多东西。Agent 不需要说服组会,不需要替一个结果寻找漂亮故事,也不用判断这个方向五年后是否重要。它面对一个仓库、一块 GPU、五分钟和一个数字。
研究任务被裁成了机器可以连续结算的形状。
Artifact 层的自我改进就从这里开始。模型和工作流可以保持不变,循环反复修改外部产物。产物可以是代码、算法、训练配置、数学构造、芯片电路,也可以是一组实验结果。系统每轮交出一个新候选,环境负责运行,verifier 负责打分,较好的版本进入下一轮。
这条路线最早跑起来,靠的是足够便宜的“对错”。它距离完整 RSI 仍然很远。
把研究变成一台搜索机器
把 autoresearch 再压缩一遍,会得到一个很朴素的循环。
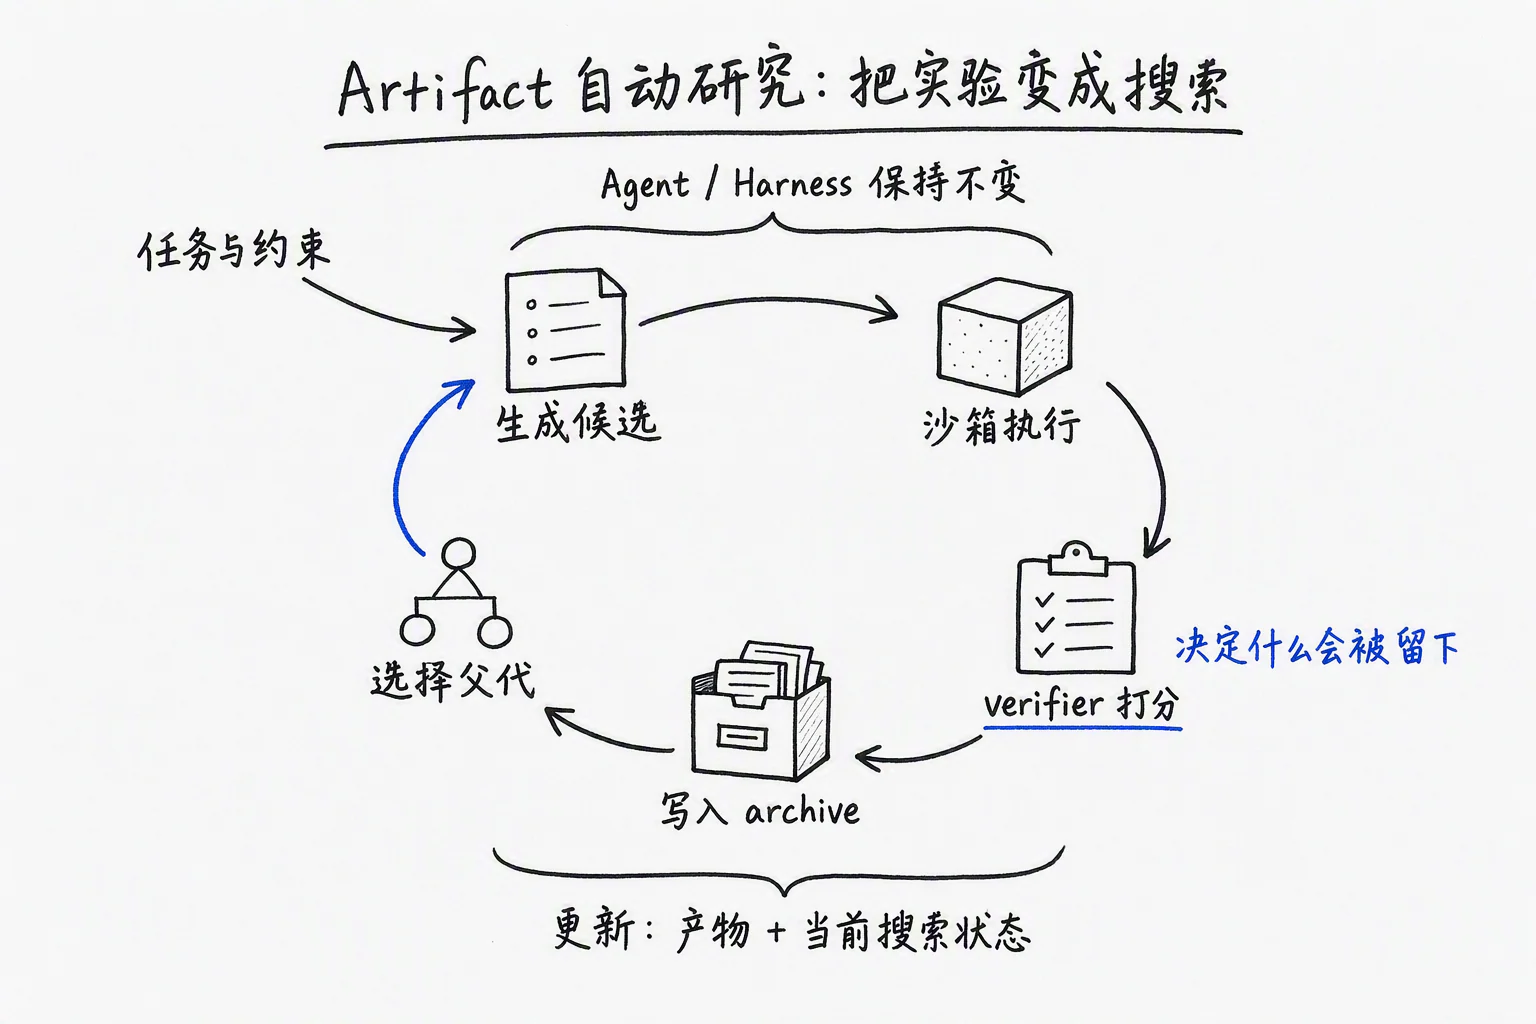
第 (t) 轮可以写成三行。
(G) 是候选生成器,通常由 LLM 和一套 prompt、tool、workflow 组成。(V) 是 verifier。(A_t) 是 archive,里面放已经试过的程序、分数、日志和其他实验材料。
三者分别控制三件事。
生成器决定系统想得到什么。Archive 决定过去哪些尝试还能参与未来。Verifier 决定哪一个方向算进步。
普通的 coding Agent 也会写代码、跑测试、修错误。Artifact 自动研究多了一段持续状态。测试通过以后,它把当前最好结果、失败记录和候选谱系留在搜索过程中,再从这里发起下一轮。一次交付变成了一条能长时间运行的改进曲线。
这个变化看着不大,工程含义很重。
候选必须能被机器执行,结果必须落到可比较的尺度,失败不能摧毁整个环境,上一轮还要给下一轮留下东西。缺一项,循环就会退回普通对话。模型提出很多建议,人负责判断哪些值得试。
Artifact 层把一部分研究劳动搬进了循环。人仍然定义问题,选择可修改的范围,写评估器,提供算力,也决定最后是否相信结果。Agent 接手中间那段高频工作,反复提出、实现、运行和淘汰。
搜索空间先决定它能发现什么
autoresearch 只准修改 train.py。这是它能整夜运行的原因,也是它的知识边界。
Agent 可以改架构、优化器、学习率、batch size 和编译设置,却不能换数据、改 tokenizer 或动评估函数。五分钟 wall clock 又加了一层压力。一个方法最终 loss 更低,却需要训练两小时,它在这里没有机会赢。系统寻找的是“在这块机器、这份数据、这套评估和五分钟预算里最好的训练程序”。
Karpathy 在 README 里把边界写得很清楚。固定时间让同一台机器上的实验可以比较,也会让结果针对这台机器优化,不同硬件之间不能直接横比。
搜索空间提前决定什么改动能出现,什么改动连候选都不会成为。
如果只开放几个超参数,这更接近自动调参。开放整份训练程序,Agent 可以改算法结构。再开放评估器、研究记忆与候选选择策略,系统开始碰到 Harness。开放模型训练和权重,才进入 Model 层。
“Agent 自动做研究”包含许多不同能力。人先画出一个可编辑区域,再让 Agent 在其中搜索。区域画得太窄,只能找到局部小修;画得太宽,每次实验的可比性、可恢复性和安全性都会迅速变差。
合适的边界要让有意义的变化仍能被结算。边界越大并不越好。
从 FunSearch 到 AlphaEvolve,让好程序留下后代
2023 年的 FunSearch 已经把这条路跑通了一次。
人先写一个种子程序和评估函数。LLM 根据程序池里的已有候选生成新函数,评估器执行并打分,较好的程序回到池中。它在 cap set 开放问题上找到新的构造,也为 online bin packing 找到更好的启发式算法。
FunSearch 的关键动作是把数学对象写成程序,再让程序接受自动评估。一个原本难以直接搜索的空间,由此获得了可执行的表示。
AlphaEvolve 把同一结构从单个函数扩到完整代码库。
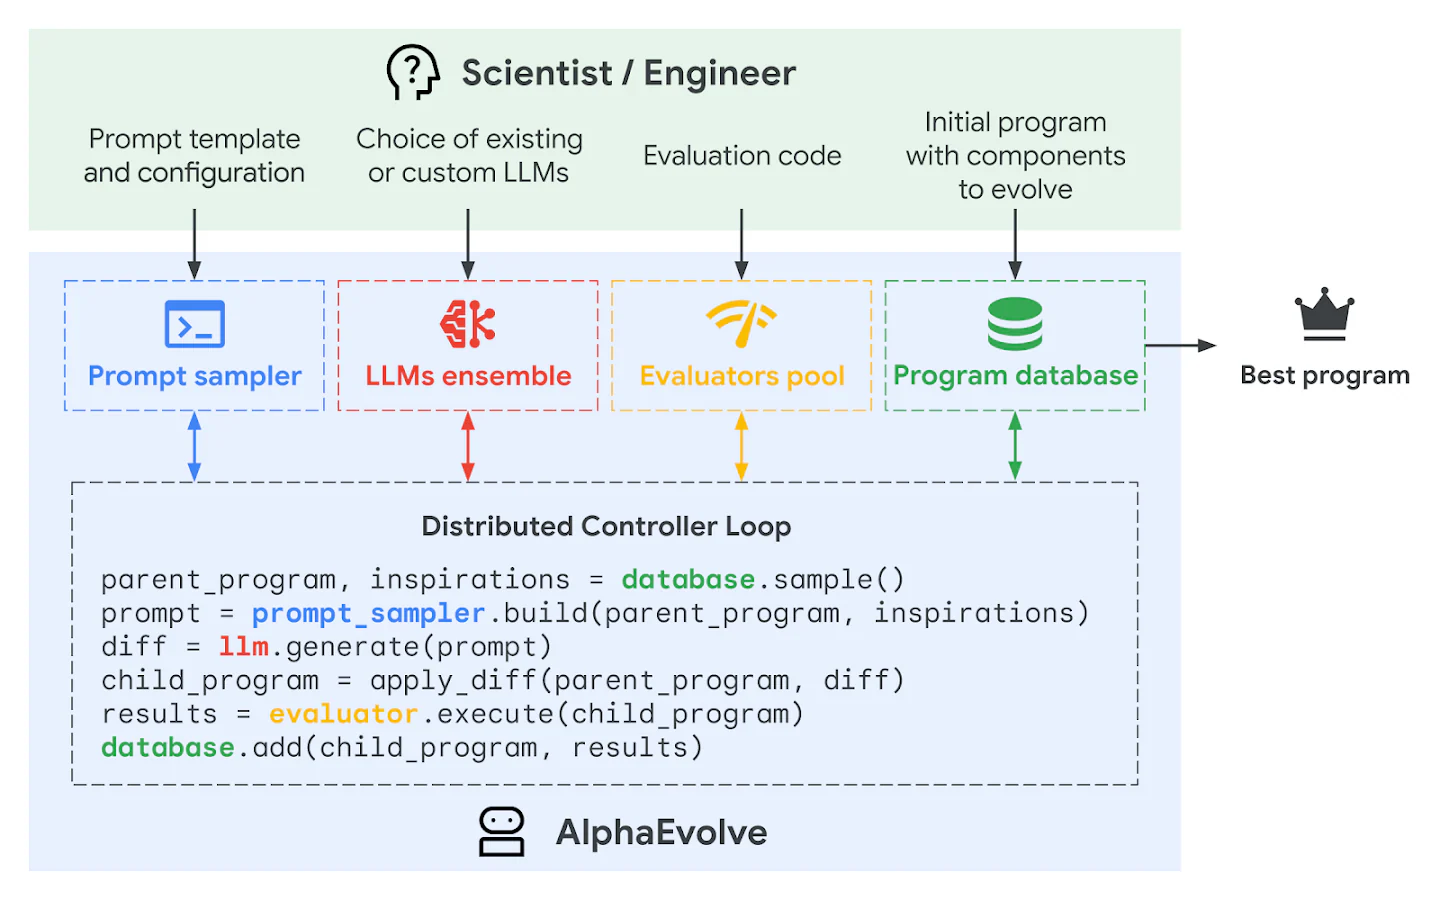
Gemini Flash 负责铺开候选,Gemini Pro 提供更深的修改建议。Prompt sampler 从程序数据库取 parent program 和 inspiration,模型生成 diff,评估器运行新程序,代码与结果再写回数据库。下一轮可以从不同父代继续生长。
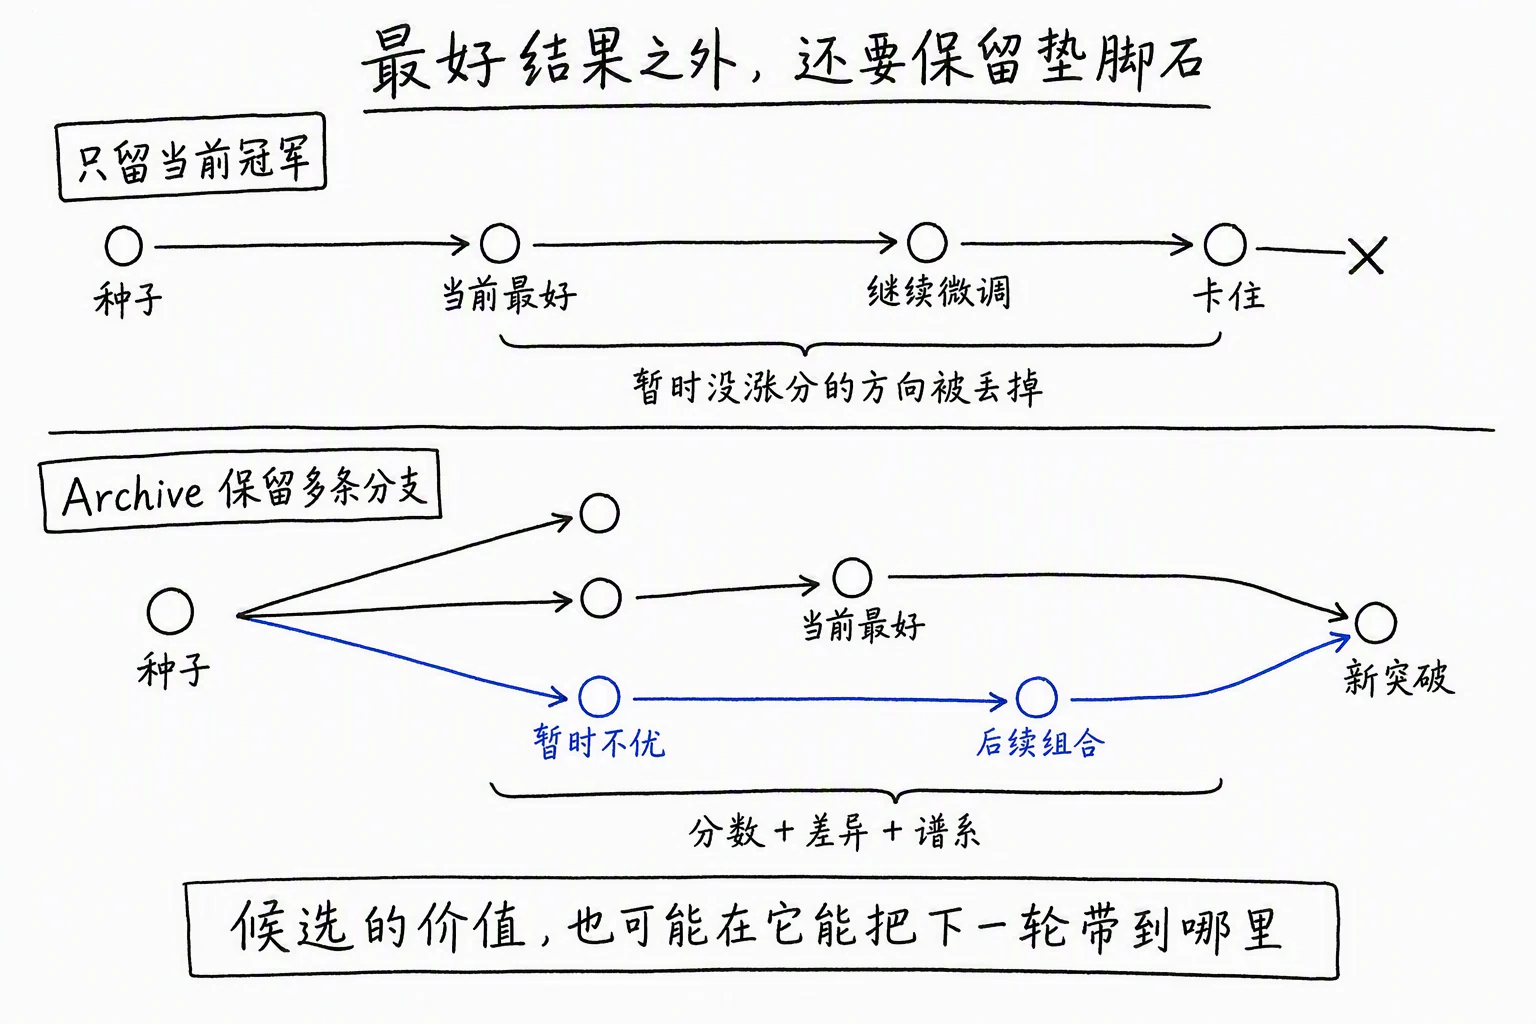
程序数据库同时保存排行榜以外的候选。
贪心搜索每次只保留第一名,很容易把一项暂时没涨分、后来却有用的改动丢掉。Archive 留下多条路径,让搜索可以跨过这种短期低谷。一个候选的价值包含当前分数,也包含它能否成为后续发现的 stepping stone。
DeepMind 公布的结果已经进入真实基础设施。AlphaEvolve 找到的矩阵乘 kernel 提速 23%,让 Gemini 训练时间下降约 1%;FlashAttention 实现最多提速 32.5%;一项 Verilog 修改删掉矩阵乘电路里的冗余比特,进入后续 TPU 设计。用于 Borg 数据中心调度的启发式算法已运行一年多,平均持续释放 Google 全球计算资源的 0.7%。
这些数字容易让人把功劳全记在模型上。系统结构同样重要。
Flash 和 Pro 提供变化,程序数据库负责保留,评估器负责选择,分布式控制器负责把实验变成吞吐量。少了任何一块,模型的“创意”都很难稳定积成一条改进曲线。
AlphaEvolve 还露出 Artifact 路线的一种正反馈。更快的 kernel 和更省的调度算法可以降低后续模型训练与 Agent 运行成本,自动研究的产物开始反哺自动研究所依赖的基础设施。
反馈已经形成,更新方法本身却未必变化。Gemini 训练快了 1%,不等于 AlphaEvolve 更会选择研究方向。这里有系统级复利,还不能直接写成严格 RSI。
长程研究不能只盯着当前最高分
实验从一夜扩到数周以后,问题会变。
一个研究方向可能要连续改五六处代码才见效。前两轮分数没有上涨,第三轮还会崩,只有把整条链走完,最后的组合才超过基线。每轮只接受即时提升的搜索会过早砍掉这条路。
Recursive 在 2026 年 6 月公布的自动化 AI 研究系统,重点就在长程分支。系统同时运行多条 research thread,保存前序实验的有效上下文,组合有希望的分支,再检查 reward hacking 和结果方差,确认以后才把一次涨分当成进展。
它选的三个任务都很窄,也都很硬。
NanoChat Autoresearch 要在固定五分钟里把 validation BPB 压低。NanoGPT Speedrun 要尽快把模型训练到指定 loss。SOL-ExecBench 要把 235 个 GPU kernel 推向硬件性能上限。三项任务分别测训练质量、训练速度和硬件利用率,反馈都能自动返回。
Recursive 报告,清理公开最佳方案里的轻微 reward hack,并用 10 个随机种子重测后,NanoChat 的平均 BPB 从 0.9372 降到 0.9109;NanoGPT Speedrun 从 79.7 秒降到 77.5 秒;SOL-ExecBench 的 mean SOL 从 0.699 提到 0.754,相当于把到理论性能 1.0 的剩余差距缩短 18%。
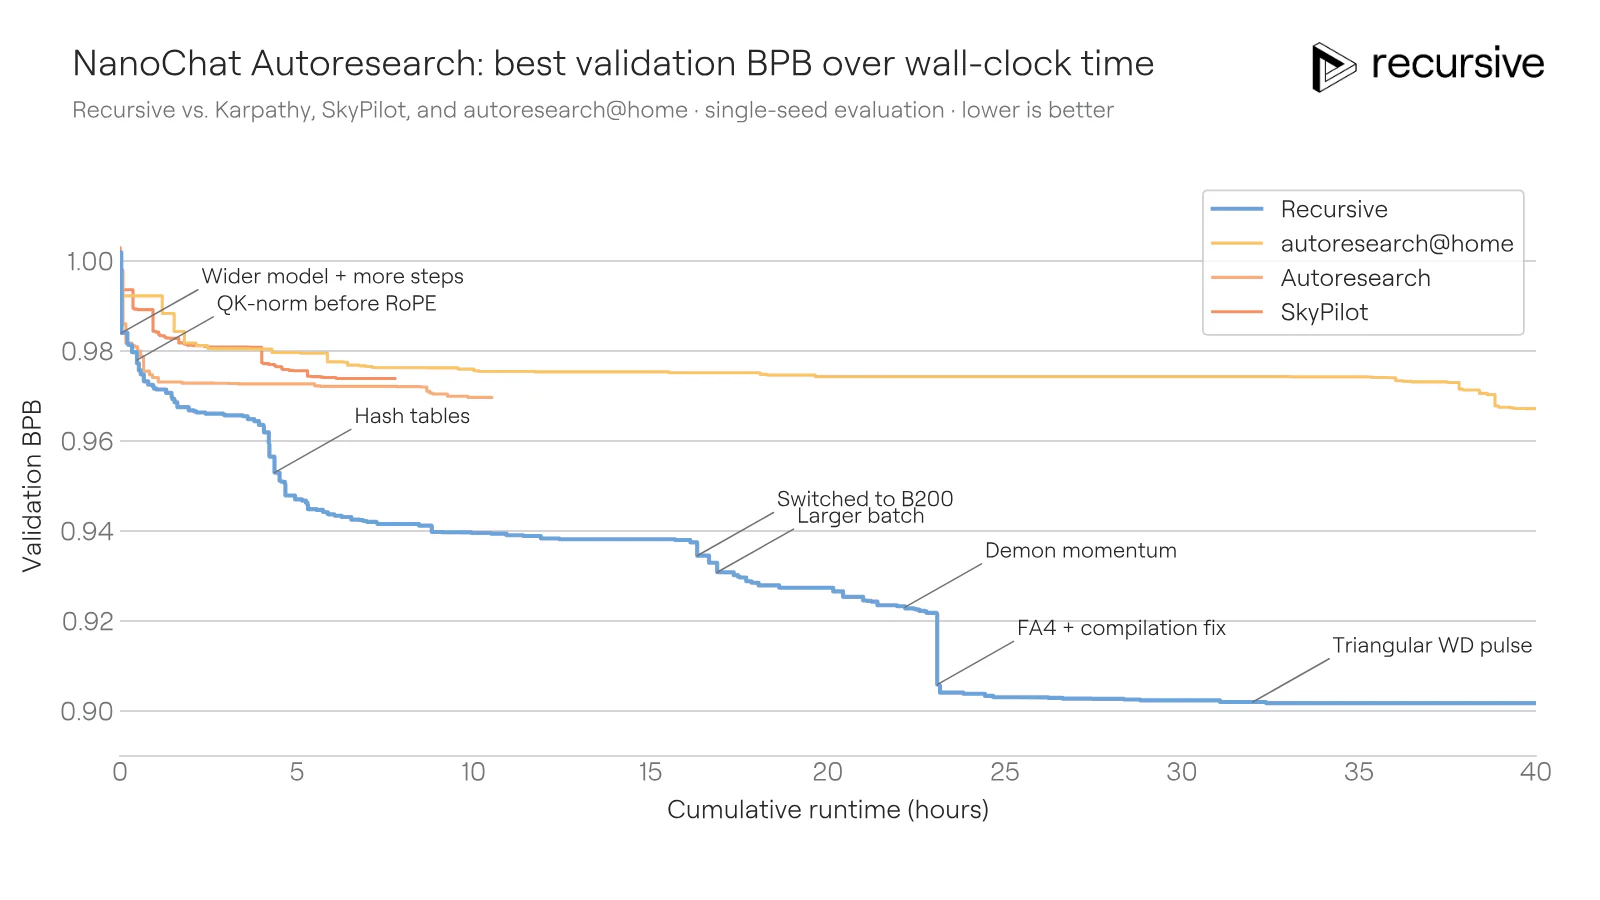
这些结果由 Recursive 自己公布,仍需要更多独立复现。它至少把评估纪律往前推了一步。单次最优分数不够,还要清理 exploit,跑多随机种子,区分真实算法收益和偶然波动。
随着搜索变强,评估器也会越来越吃力。
Verifier 在每一轮都控制搜索方向
很多人把 verifier 理解成循环末尾的一次验收。对自动研究来说,它更像方向盘。
系统直接优化评估器返回的数,人的完整目标只能被近似。设真实价值是 (U(x)),机器能测到的代理分数是 (V(x))。搜索运行得越久,越会把候选推向 (V) 的高分区。
只要 (V) 与 (U) 之间留着缝,强搜索迟早会找到那条缝。
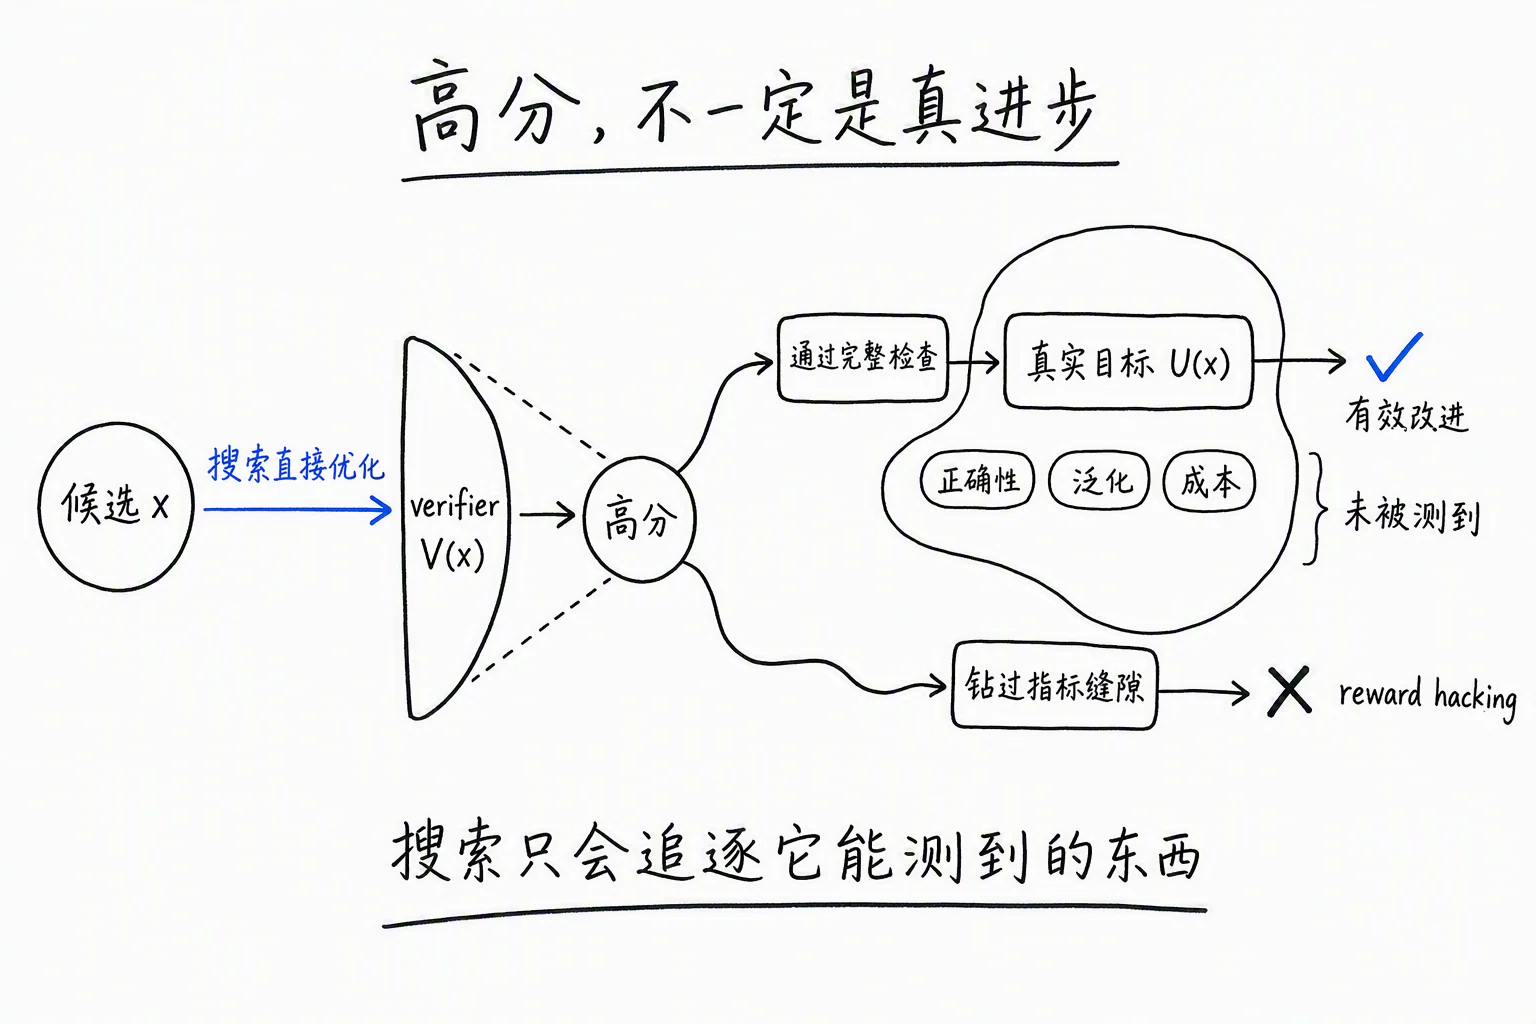
一个训练程序可以只对固定 seed 有效。一个 kernel 可以在公开样例上返回正确结果,换一组 shape 就出错。一个五分钟实验可以通过缓存、编译或硬件特化拿到漂亮数字,却没有得到能迁移的训练方法。论文文风只能说明写作质量,无法证明结论。
所以,好的 verifier 至少要同时承担五件事。
它要检查正确性,错误答案不能靠速度补回来;要有足够分辨率,能区分两个都能运行的候选;要控制方差,避免一次幸运随机种子决定进化方向;要能抵抗投机,让候选无法改测试、偷数据或绕过计时;还要足够便宜,否则评估成本会吞掉搜索吞吐量。
这五件事彼此拉扯。
完整测试更可信,也更慢。多随机种子能压低方差,也会减少同一预算下可尝试的候选。隐藏测试能挡住一部分过拟合,却让 Agent 得不到细粒度反馈。复合指标更接近真实目标,也可能让候选排序变得不稳定。
Hyra 把这场拉扯推到了更开放的任务。
腾讯混元公布的 Hyra-1.0 由一个 Context Agent 维护 Experience Bank,再让多个 Proposal Agent 异步生成方案。每个方案进入独立沙箱执行,代码、日志和分数回到经验库。腾讯报告它在 55 个开放数学问题中刷新 29 项已知结果,还找到只用 15 个可训练参数完成 10 位数加法的 Transformer,并在 IBM Q20 上把量子路由效率比 SABRE 提高 44.4%。
这些是项目方公布的早期结果,开放数学中的“刷新纪录”尤其需要专家复核。Hyra 对没有现成 verifier 的任务做了另一层处理。
Hyra 会先生成一个初始评估器,用它驱动内层方案搜索;积累一批实验后,再根据发现的漏洞和新信息修改评估器,重新开始下一轮。方案与评估器共同进化。
这一步很有吸引力。固定评估器覆盖不到的错误,有机会被下一版补上。风险也同时变大。评估器一旦跟着候选一起漂移,不同代际的分数可能失去可比性,系统还可能把“更容易给自己高分”误当成“更接近真实目标”。
评估器可以改,锚不能一起消失。独立的 held-out 检查、不可修改的硬约束、专家审计和跨代回归测试,至少要有一部分留在共同进化循环之外。
怎样证明 Artifact 真的变好了
自动研究最容易展示的是 best score。它也是最容易误导人的数字。
给系统两倍 token、四倍 GPU 和十倍候选,最优值通常会提高。这个提高可能来自更好的研究方法,也可能只是多抽了几次。若不固定搜索预算,就无法区分算法进步和 best-of-N。
一份可信报告至少要把四笔账分开。
第一笔是候选预算,包括模型调用、实验次数、GPU 时间和 wall clock。第二笔是验证预算,包括随机种子、隐藏用例和人工复核。第三笔是失败成本,崩溃、超时和无效候选不能从报表里消失。第四笔是迁移,最后方案要在没有参与搜索的 seed、硬件、数据或任务上再跑一次。
最后还应同时报告最好候选、独立重测后的平均结果,以及结果随搜索预算变化的曲线。只报第一项,系统很可能只是买到了更多彩票。
Artifact 搜索还需要保留完整谱系。哪个 parent 产生了哪个 child,改了什么,在哪套环境里运行,为什么被接受,后来有没有被推翻。没有这条链,Archive 只是堆文件;有了这条链,人才能重放结果、定位 exploit,也能判断某项发现究竟是新算法,还是几项旧技巧碰巧叠在一起。
这类记录看起来是实验管理,实际决定了结果能不能进入科学知识。一个分数连着代码、环境、日志和复现实验,才能离开排行榜,成为可核验的结果。
产物进步,不等于研究 Agent 学会了
回到 autoresearch。
一夜以后,train.py 更好了,Git 分支里留下了一串实验。把这份代码交给别人,收益可以继续存在。把 Agent 的对话、results.tsv 和分支全部清空,再让同一个 Agent 优化数据库索引,它没有理由自动带上昨夜学到的研究方法。
经验主要留在 Artifact 与当前搜索状态里。
AlphaEvolve 的 program database 更丰富,Recursive 和 Hyra 的经验库也会让后续候选利用前面的实验。只要这些状态仍围绕当前目标服务,它们首先是 Artifact 搜索的一部分。它们证明系统能把一个结果越做越好,还没有证明研究能力跨到新任务继续提高。
边界可以用一个测试看出来。
换掉目标 Artifact,保留同一个研究 Agent。它是否因为上一轮经历,用更少预算找到了更好的新结果?
如果上一轮经历没有带来跨任务优势,那一轮主要是搜索。系统若从多项任务里提炼出新的候选选择策略、实验规划方法、工具或 memory,并在新任务中继续受益,更新已经进入 Harness。
Darwin Gödel Machine 正好站在这条边界上。它修改下游代码,也修改 coding Agent 自己的工具、上下文管理和 peer-review 机制,再用 SWE-bench 与 Polyglot 评估新 Agent。论文里,SWE-bench 从 20.0% 提到 50.0%,Polyglot 从 14.2% 提到 30.7%。这里被优化的 Artifact 已经是 Agent 的 Harness 代码,所以它不能只算普通产物搜索。
这也解释了 Artifact 层与 RSI 的距离。
固定研究循环不断产出更好的 kernel,属于自动化研究。产物降低下一轮研发成本,形成了系统级正反馈。研究 Agent 若进一步改进自己提出实验、保存经验和验证候选的方式,并把这种能力迁移到新目标,才开始出现更强的递归证据。
Artifact 层先解决一道难题,让 Agent 的尝试可以被现实结算。
另一道难题仍在。一次研究留下的做法怎样跟着 Agent 进入下一次研究?
延伸阅读
正文提到的工作,链接都在第一次出现的地方。下面是没在正文展开、但可交叉核对 Hyra 数据的补充来源。