RSI 综述 1|AI 自我改进的三条路线
AI 的“自我改进”可以落在三个地方:改产物、改 harness、改模型权重。这篇把 2026 年的代表工作按这三层理一遍。
2026 年 3 月,Karpathy 放出了一个很小的项目,autoresearch。
Agent 只改一个 train.py。每次训练固定跑五分钟,再用同一个验证指标决定保留还是丢弃。默认设置下一小时能做约 12 次实验,一夜接近 100 次。仓库展示的第一次运行里,83 次实验留下 15 次改进。
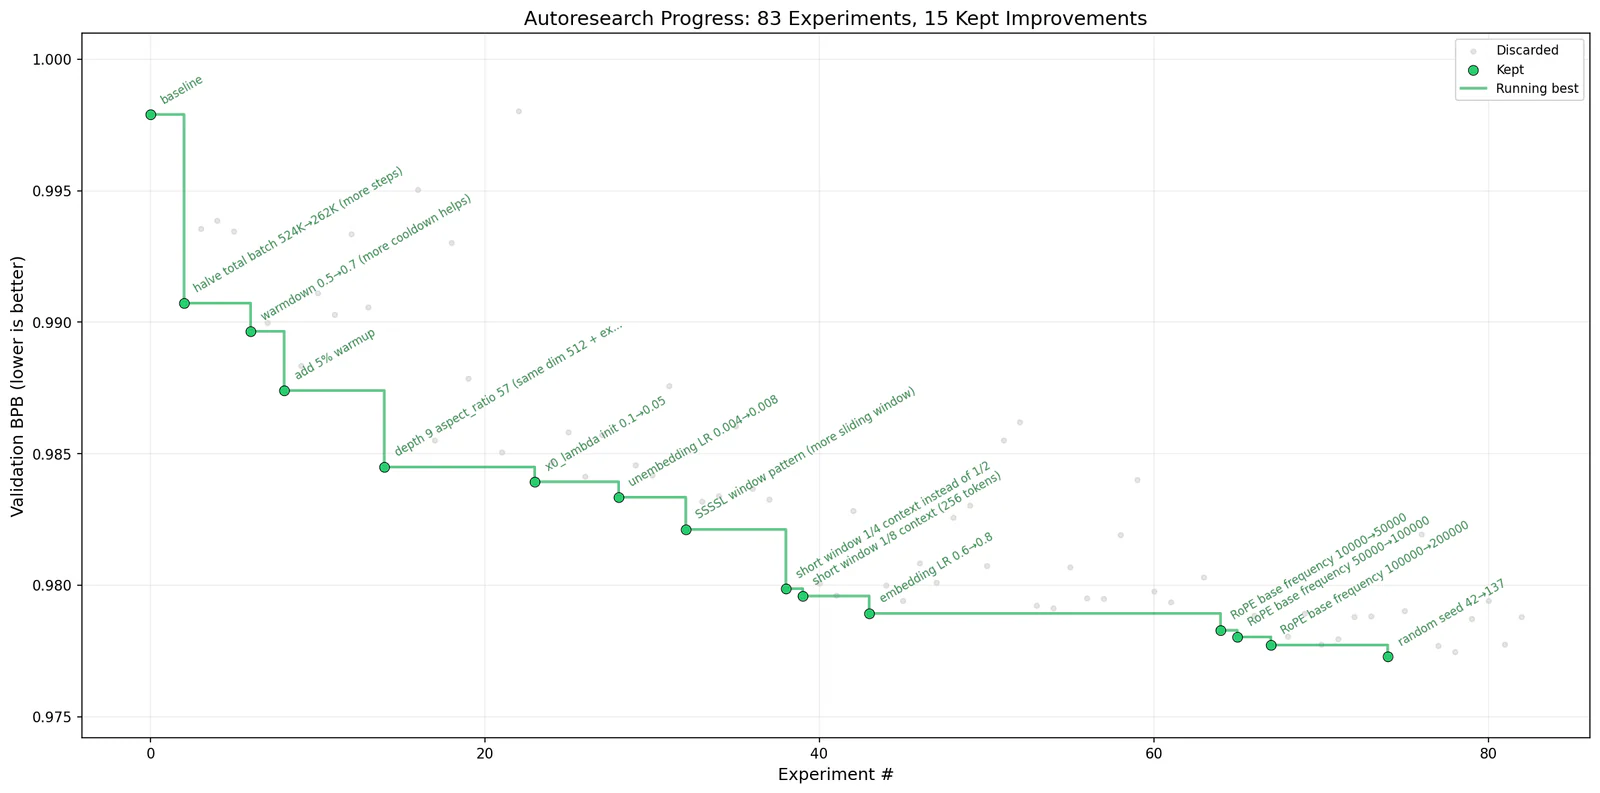
它没有宣称自己实现了 RSI,也没有让模型重写权重。它只是让 coding Agent 读代码、改实验、启动训练、读取结果,再决定下一步。
这个“只是”已经很关键。研究过去由人守着跑,今天开始能在夜里自己转起来。
接下来几个月,更多动作挤到了一起。
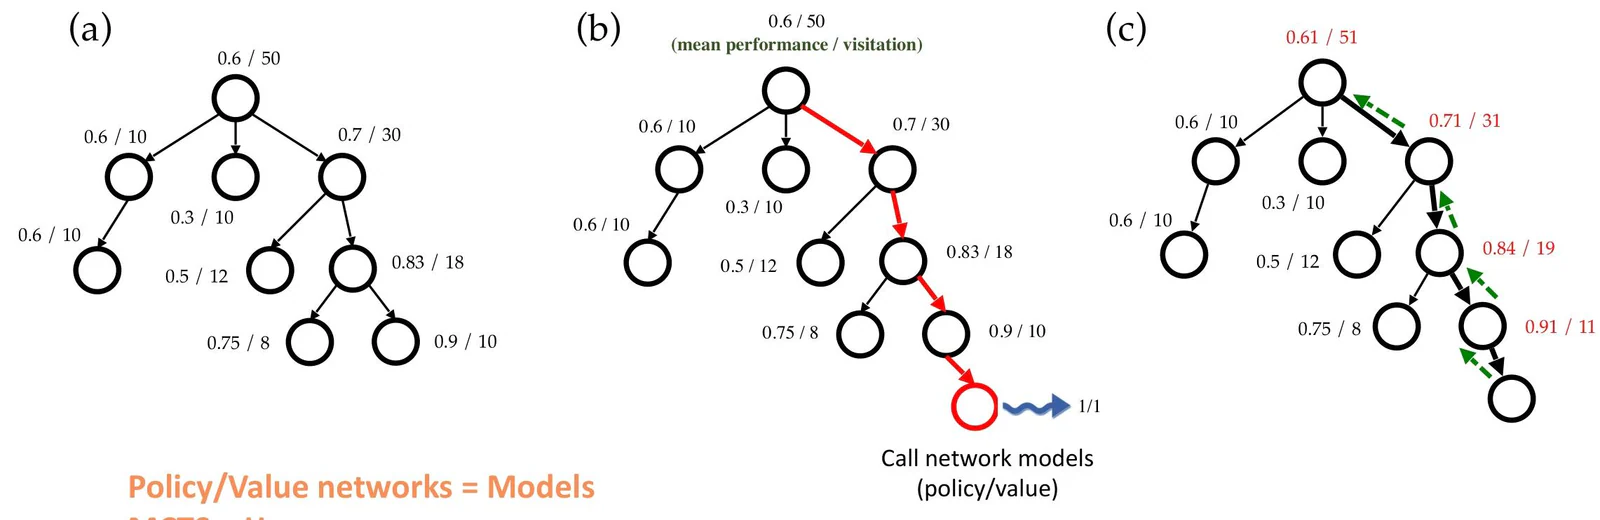
4 月,田渊栋在 ICLR 的 RSI Workshop 回顾 AlphaZero 与 ELF OpenGo。他强调,自我改进从来都不只发生在模型里。Policy 和 value network 是 Model,负责搜索与选择的 Monte Carlo Tree Search 是 Harness。大模型把通用知识、coding 和概念理解装进同一个模型以后,这套结构才有机会从围棋走向开放式研究。
他后来与 Richard Socher、Jeff Clune、Tim Rocktäschel 等人共同创立 Recursive Superintelligence。6 月,Recursive 公布自动化 AI 研究系统的首批结果。系统会提出想法、实现、跑实验、验证,再选择下一项实验;多条研究分支共享历史信息,还要检查 reward hacking 和结果方差。
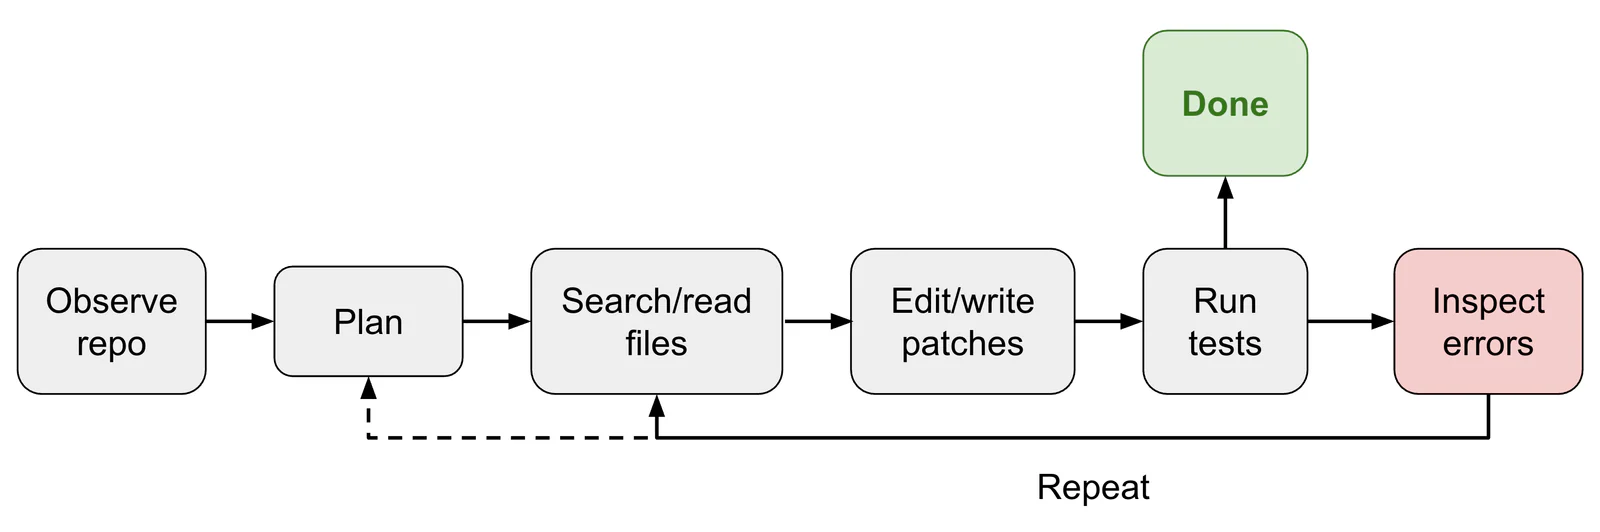
7 月,翁荔发表《Harness Engineering for Self-Improvement》。她把近期可行路线放在 Harness。Harness 已经不只是 prompt 模板,它更接近一套 Agent runtime,控制模型怎样观察、行动、记忆、调用工具、检查结果和继续改进。
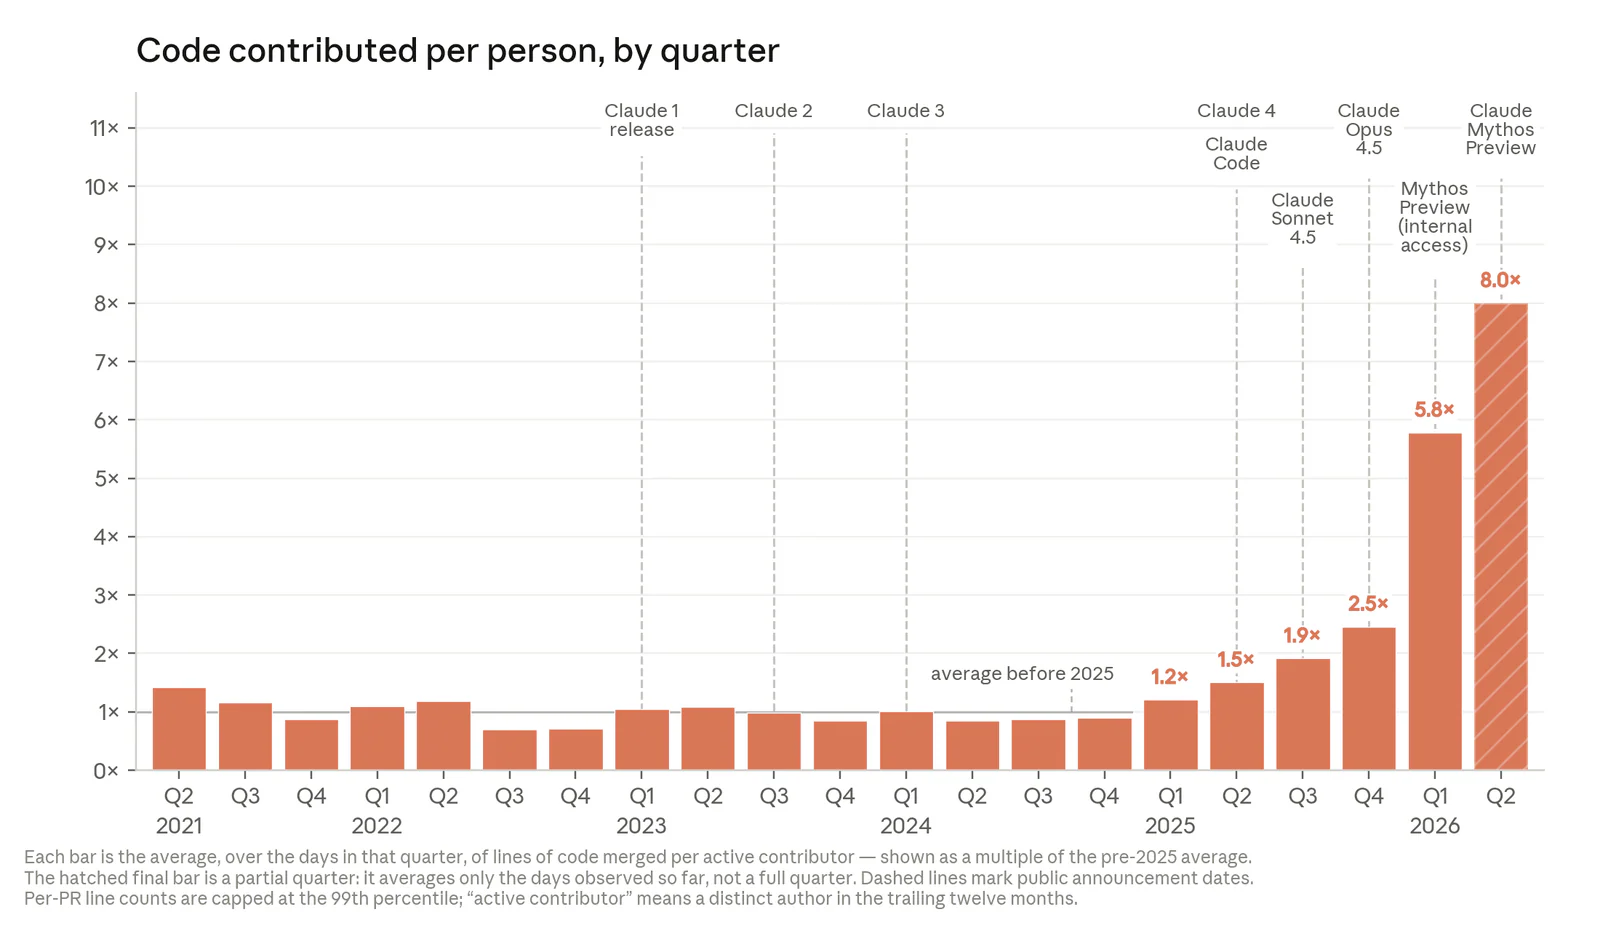
Anthropic 也公开了一批内部数据。截至 2026 年 5 月,Claude 撰写了 Anthropic 合入代码的 80% 以上。2026 年第二季度,每位工程师每天合入的代码量约为 2024 年的 8 倍。Anthropic 明确提醒,代码行数会夸大真实生产率;这组数据仍然说明,AI 已经进入生产下一代 AI 的研发过程。
同一时期,Sakana AI 成立 RSI Lab,MiniMax 让 M2.7 深度参与迭代自己,自动研究、self-evolving agent 和 recursive self-improvement 开始出现在同一张路线图上。
半年里,Karpathy 放出夜跑的 autoresearch,田渊栋去创业做自动研究,翁荔把赌注押在 Harness,Anthropic 亮出 80% 代码由 Claude 写的数据。这些事凑在同一张路线图上,看起来像在合力推同一件事。
它们没有在做同一件事。
为什么偏偏是现在
RSI 的概念不新。I. J. Good 在 1965 年就讨论过能设计更好机器的“超智能机器”。今天变化的是执行条件。
第一,coding Agent 的工作半径变长了。
模型过去可以补一段代码,今天开始能操作代码库、终端、浏览器和训练集群,能监控后台任务,也能在中断后从文件和日志恢复。一个系统只有持续行动,研究才可能形成完整回路。
第二,一部分研究任务有了便宜的反馈。
代码有测试,训练实验有 loss,kernel 有运行时间,数学构造可以由程序检查。autoresearch 把问题限制为一个文件、五分钟和一个指标,正是为了让每次修改迅速结算。反馈短,系统才有机会在固定预算内多做实验。
第三,改进的对象进入了 AI 研发本身。
AI 写出更快的 kernel、改进训练配置或重构 Agent 工作流,这些收益会继续用于训练和运行后续系统。一次自动化不再只节省一项任务,它可能提高下一轮研发的速度。
不过,只要系统反复生成、评估和修改,就能叫 RSI 吗?
不能。
循环不等于学习
先看一个 coding Agent。
它写完代码,运行测试,发现失败,读报错后修改,最后让测试通过。当前任务确实变好了。
任务结束后,把对话和临时状态全部删掉,再让同一个 Agent 处理另一个仓库。如果它没有留下 memory、skill 或 workflow,也没有改变模型权重,第二次任务仍从原来的起点开始。
这一轮发生了搜索和纠错,没有发生跨任务学习。
所以,判断 self-evolving 不能只看外面有没有循环。还要问三个问题。
- 哪个持久状态被修改了?
- 修改能不能跨过当前任务继续存在?
- 后续任务有没有因为它变好?
第一问决定路线,第二问决定经验能保存多久,第三问才区分“自我修改”和“自我改进”。
而路线的分界,落在一个很普通的问题上。
这次经验最后写进了哪里?
三条路线,三种经验载体
现代 Agent 可以先拆成三个部分。
Model 接收输入并生成响应。Harness 把模型组织成能持续工作的系统,负责 loop、prompt、memory、tool、skill、subagent、权限和评估。Agent 最后交出的代码、算法、论文、训练配置或机器人策略,属于 Artifacts。
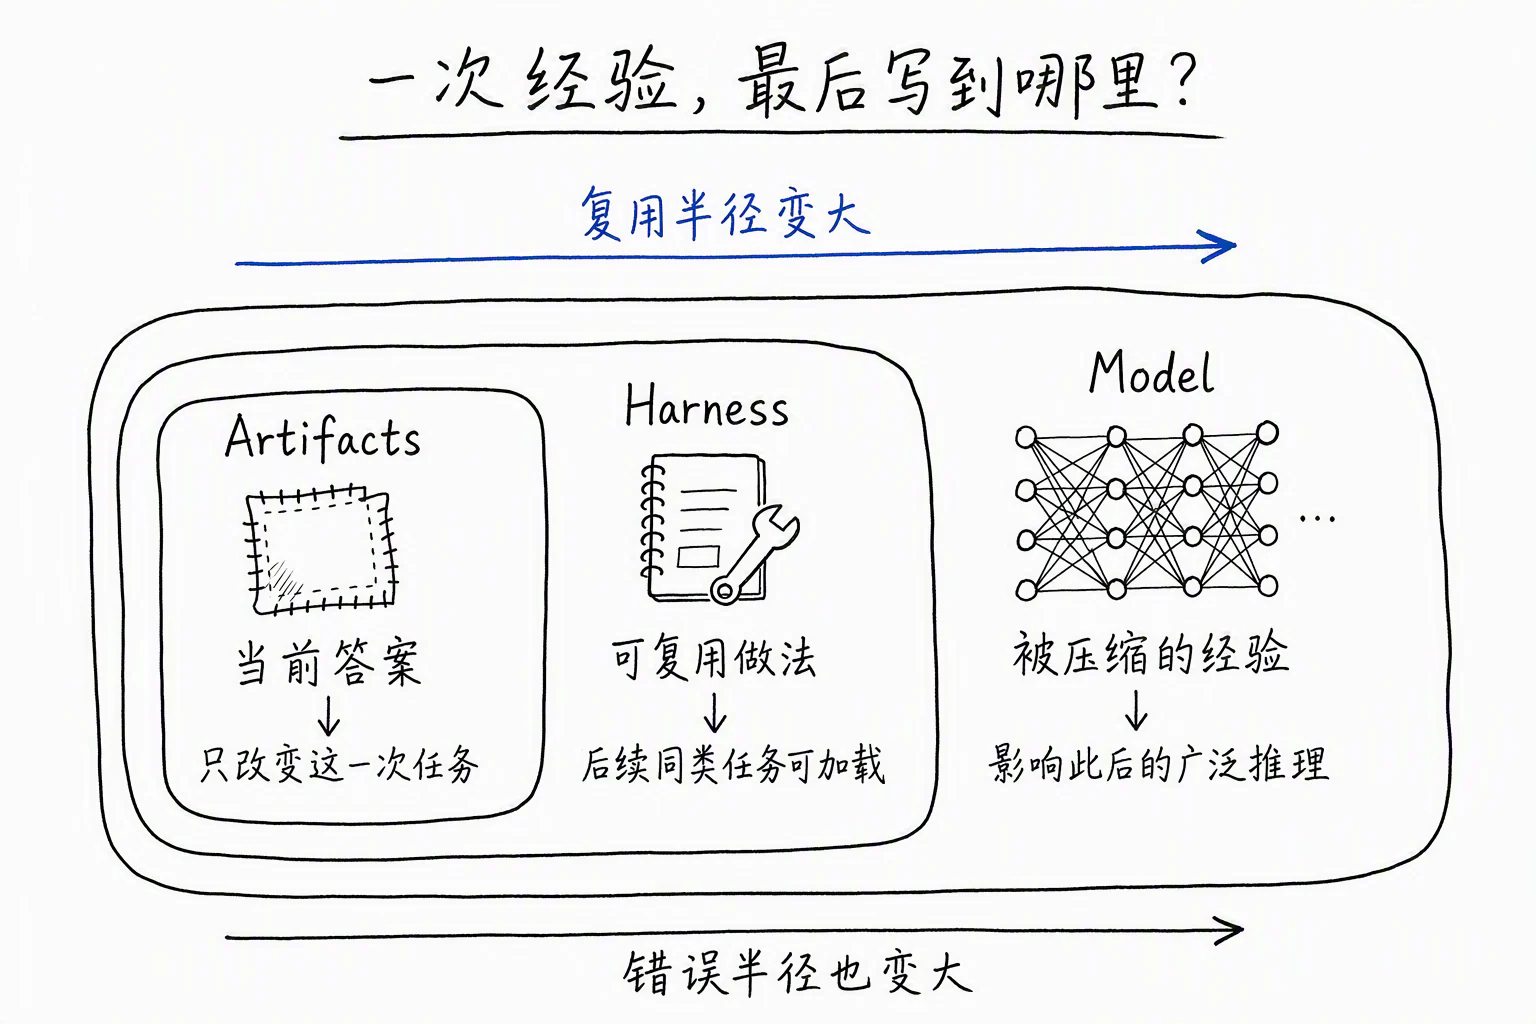
三个对象对应三条自我改进路线。
| 路线 | 修改什么 | 典型反馈 | 经验主要影响哪里 | 常见回退方式 |
|---|---|---|---|---|
| Artifact | 代码、算法、论文、实验配置 | 测试、运行时间、验证分 | 当前目标或相近产物 | 换回旧版本 |
| Harness | prompt、memory、skill、tool、workflow | 轨迹、回归测试、held-out 任务 | 后续同类任务 | 删除条目、回滚配置 |
| Model | 模型参数与策略 | 答案、执行器、奖励、偏好 | 使用该模型的广泛任务 | 回滚 checkpoint 或重新训练 |
保存位置会同时改变四件事,复用范围、修改成本、错误半径和可逆性。
经验留在 Artifact,影响最窄,也最容易定位。经验进入 Harness,可以跨任务使用,但要被正确检索和执行。经验写进 Model,不必显式加载,影响会扩散到模型此后的大量推理,一条错误经验也更难单独删除。
三层因此也是三种经验载体。
分类依据是哪个持久状态被修改,执行修改的是人还是 LLM 都不影响归类。
LLM 自动改 train.py,变化落在代码产物,属于 Artifact。LLM 从失败里写出 SKILL.md,后续任务会加载这份外部状态,属于 Harness。训练器拿模型生成的轨迹更新参数,才属于 Model。
同一个系统也可能同时包含三条回路。外层 Agent 改训练代码,训练代码产出新模型,新模型又参与修改下一版 Agent runtime。判断具体一项工作时,要看论文或系统当前测量的主要更新对象,不能只看标题里有没有“self”或“recursive”。
Artifact 层
这一层负责把当前结果做得更好。Artifact 路线保持 Model 与 Harness 基本不变,循环修改输出。
最有代表性的工作是 Google DeepMind 的 AlphaEvolve。
Gemini Flash 先铺开候选,Gemini Pro 提供更深的修改建议。候选程序交给自动评估器运行和打分,再存进一个程序数据库。这个数据库不是普通结果列表,它会保留较好的程序,决定下一轮 prompt 应该参考哪些已有解法。模型提出变化,评估器结算结果,进化搜索继续采样。
这套循环已经进入真实基础设施。AlphaEvolve 找到的矩阵乘 kernel 提速 23%,让 Gemini 训练时间下降约 1%;它还把 FlashAttention 实现最多提速 32.5%,并提出了进入后续 TPU 设计的 Verilog 修改。每次被保留下来的,是一段更好的代码或算法。
这就是它属于 Artifact 层的原因。Gemini 可以参与整个搜索过程,模型权重与 Agent 工作流却不必在每轮发生持久变化。最终产物进步了,换一道不同的问题,搜索系统仍可能从头开始。
Artifact 层最先跑起来,也因为代码、算法和训练配置通常有 verifier。测试判断正确性,运行时间比较快慢,验证损失衡量训练结果。反馈稳定,搜索就能自动转很多轮。
Harness 层
这一层负责把做法留给下一次。代表工作可以看 2026 年的 Self-Harness。
它先让固定模型和当前 Harness 去跑 Terminal-Bench 2.0,收集成功与失败轨迹。系统把相似失败聚在一起,找出模型反复出现的弱点;再提出几项范围很小、各自对应一个失败原因的 Harness 修改。候选不能提出后就直接上线,还要通过回归测试。没有退化的改动才会进入下一版 Harness。
整个过程中,模型权重、工具集、预算和评估器保持不变。被修改的只有模型周围的操作方式。对 MiniMax M2.5,held-out pass rate 从 40.5% 升到 61.9%;Qwen3.5-35B-A3B 和 GLM-5 也得到提升,而且三种模型收到的修改并不相同。系统保存的是针对各自失败模式的做法。
这个过程可以落到更普通的工程场景。Agent 连续几次修完一个 bug,却总忘记搜索其他文件里的同类模式。系统把“修复后检查全仓库”写成 workflow 或 skill,以后遇到相近任务,这项做法会跟着 Agent 一起出现。经验由此从 Artifact 进入 Harness。
Harness 的更新可以是一条 prompt、一段 memory、一项 skill、工具接口,或者多 Agent 的路由与验证分工。它比 Artifact 更能跨任务复用,又比权重显式。改动能逐条查看,可以限制在 session、project 或 global,也可以单独回退。
代价同样在外面。规则会冲突,memory 会过期,skill 会越积越多;弱模型还可能找不到该加载的 Harness,或者加载以后不按它执行。更新得容易,不代表证明有效也容易。
Model 层
这一层把经验写进参数。更贴近 self-evolving 系统形态的代表工作,是 Mohamed bin Zayed University of AI 等团队的 EvoLMM。
团队冻结 Qwen2.5-VL 的主干,在同一基座上挂了两组独立 LoRA。一组是 Proposer,负责从无标注图片里生成问题;另一组是 Solver,负责多次作答。系统不使用现成问答标注,也不接外部 reward model。它从 Solver 多次答案的分布里计算连续自一致性奖励,再用答案熵给 Proposer 反馈,鼓励它提出难度适中、仍然可解的问题。
两组 LoRA 在同一个在线强化学习循环里共同变化。Solver 每一步都用带 KL 约束的 REINFORCE 更新,Proposer 每五步更新一次。Solver 变强以后,原来的问题逐渐太容易,Proposer 必须继续提高问题难度;新问题又给 Solver 提供下一轮训练经验。课程随着两组参数移动,在训练过程中不断重建。
这就是它属于 Model 层的原因。持续变化的状态是 Proposer 与 Solver 的 LoRA 权重。训练完成后,新的行为已经进入 Solver adapter,下一次推理不必先检索一条 memory 或加载一份 SKILL.md。
论文报告,Qwen2.5-VL-7B 在 ChartQA 上从 84.0% 提到 86.7%,MathVista 从 68.46% 提到 70.52%,八项评测都得到提升。实验还发现,LoRA 比 QLoRA 和全量微调更稳定。改动范围小,既保住原模型已有的多模态能力,又允许两种角色分开学习。
这里的 online 只描述训练循环内边采样边更新。部署后的模型不会按每个用户请求立刻改权重。自一致性只能衡量回答是否相同,不能保证正确。五次回答一致,可能只是五次犯了同一个错;模型也可能依赖语言先验得到一致答案,没有认真看图。
经验进入权重后,不必每次检索,也不占显式上下文,更适合保存大量、模糊、难以压成规则的模式。它的复用范围最广,更新成本和归因难度也最高。训练 checkpoint 可以整体回退,某条错误经验却很难单独删掉。
EvoLMM 也把 Model 层最难的证明问题露了出来。出题者和解题者一起变化以后,分数上涨可能来自能力增长,也可能只是两者越来越适应彼此。可信评估必须留一块不随训练共同移动的参照。
三层会互相迁移
Artifact、Harness、Model 不是三个互不往来的抽屉。
第一次遇到 bug,先修当前代码,这是 Artifact 补丁。相同错误反复出现,把检查步骤写成 skill,这是 Harness 规则。规则跨许多任务都成立,再把高质量轨迹用于训练,经验才可能进入 Model。
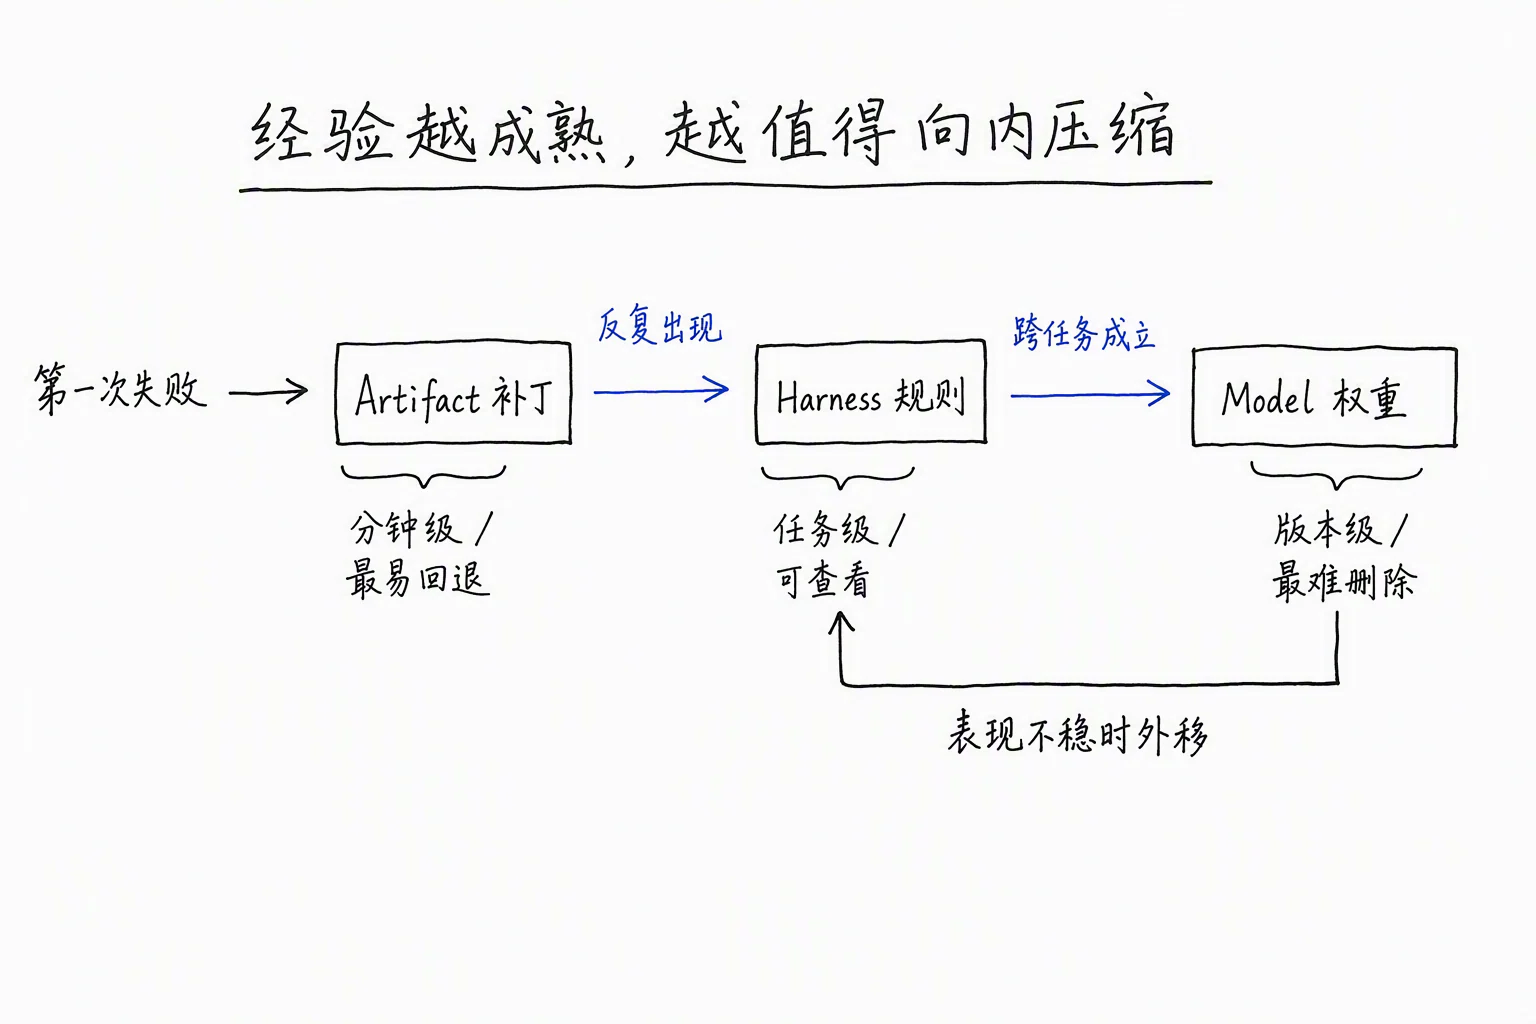
这条路径的意义在于控制错误半径。
刚出现一次的失败,原因可能判断错了。先留在容易修改的位置,风险最小。经验通过更多任务验证以后,再进入影响范围更大的状态。
迁移也可以反向发生。模型能力表现不稳时,外部评测会把失败暴露出来,Harness 再加一条显式约束或工具。某种能力若必须可靠执行,也可能从权重里的隐式倾向,重新外移成代码和 workflow。
真实系统不会追求把所有经验都塞进最深的位置。它要为不同成熟度的经验选择合适载体。
Self-evolving、self-improving 和 RSI
三层分类回答“改了什么”,还没有回答“是否构成 RSI”。
可以把一轮更新写成一句话。
下一轮系统 = 更新方法(当前系统,当前经验)Self-evolving 的范围最宽。系统根据环境、数据或反馈改变,变化可以发生在三个位置。
Self-improving 要求更高。修改要在相对稳定的评估下带来进步。系统增加十条 memory,后续任务反而更差,这叫自我修改,不叫自我改进。
Recursive self-improvement 再多一层。下一轮系统不但更强,还要更擅长制造再下一轮系统。上面关系里的“更新方法”也得继续提高。
固定搜索程序整夜优化 train.py,Artifact 会变好,更新方法没有变化,它属于自动研究,还够不上严格 RSI。
Agent 从失败里写出一条 skill,后续任务受益,这是 Harness self-improvement。若它提炼 skill 的方法始终由人固定,也还没有递归。
模型设计训练实验,训练出下一代模型,而下一代又更擅长设计后续训练,才是更强的 RSI 候选。它仍要经过预算对等、数据隔离和 held-out 任务检验,排除更多搜索和评测过拟合。
RSI 因此是整个系统的属性,不能只看模型有没有参与训练。
一个模型可以反复生成数据、更新权重,但数据流程、奖励函数和训练算法始终由人固定。它在做 self-training,生产下一代系统的方法没有提高。另一个系统可能暂时不动权重,却能改进自己怎样发现失败、怎样搜索 Harness、怎样验证候选;如果这些变化让下一轮系统更擅长继续改进,它已经触到递归问题。
证明 RSI 也不能只报最终任务分数。还要比较 successive systems 的改进能力。相同预算下,下一代能否更快找到有效修改,能否处理上一代无法处理的改进任务,能否把正确做法迁移到没见过的环境。缺少这些跨代证据,“recursive”很容易只是同一个固定循环重复了很多次。
这套地图怎样使用
看到一篇新的 self-evolving 工作,可以先暂时放下它的名字,按顺序问五件事。
- 被修改的是产物、Harness 还是权重?
- 反馈来自测试、执行器、模型 judge 还是人?
- 修改跨任务保存在哪里?
- 系统怎样验证、限制作用域和回退?
- 更新方法本身有没有随下一代系统提高?
前四问能判断它属于哪条路线,也能看出这次变化是否可信。第五问决定它是在做自动搜索、自我改进,还是已经接近严格 RSI。
目前,三条路线都已经出现了能运行的系统。
Artifact 层能长时间搜索并改进具体结果。Harness 层开始积累跨任务的 memory、skill、tool 和 workflow。Model 层也能从自身生成的轨迹、弱信号和环境反馈中更新参数。
完整 RSI 仍然少见。多数系统的搜索空间、更新规则和评估协议仍由人设计。Agent 会在给定边界里改,却很少稳定改进“怎样改”这件事本身。
Karpathy 那晚 83 次实验留下 15 次改进,改的是 train.py,不是决定要不要改 train.py 的那套程序。分清这两件事,下次再看到一篇挂着 self-evolving 的论文,至少知道该问它到底动了哪一层。
延伸阅读
正文提到的具体工作,链接都在第一次出现的地方。下面几篇是没在正文展开、但想系统了解 self-evolving 分类时值得读的综述。