RSI 综述 4|Model 层,模型怎样用自己生成的经验更新权重
自训练把经验写进权重,却没有取消监督,只是换了正确性信号的来源。数据、奖励、筛选和回退仍由外层系统组织,而权重变化本身更难逐条审计。这一层复用范围最广,也最难证明分数涨在了哪里。
SIA 的系统图里有一个容易被忽略的角色,Feedback-Agent。
一个 Task-Specific Agent 先去做任务,留下执行轨迹。Feedback-Agent 读完轨迹,要决定下一轮拧哪个旋钮。一个旋钮改 scaffold,包括工具、prompt、重试策略和搜索流程;另一个旋钮改 LoRA 权重,把难以靠提示传下去的能力直接写进模型。再往外还有一个 Meta-Agent,负责给出最初的那套 harness。
两个旋钮放进同一个循环,权重层的自我改进就不再是”训练一个新模型”那么干脆。系统在每次失败之后都要先判断一件事:这次做砸,是因为工作方式不对,还是因为模型本身就不会。
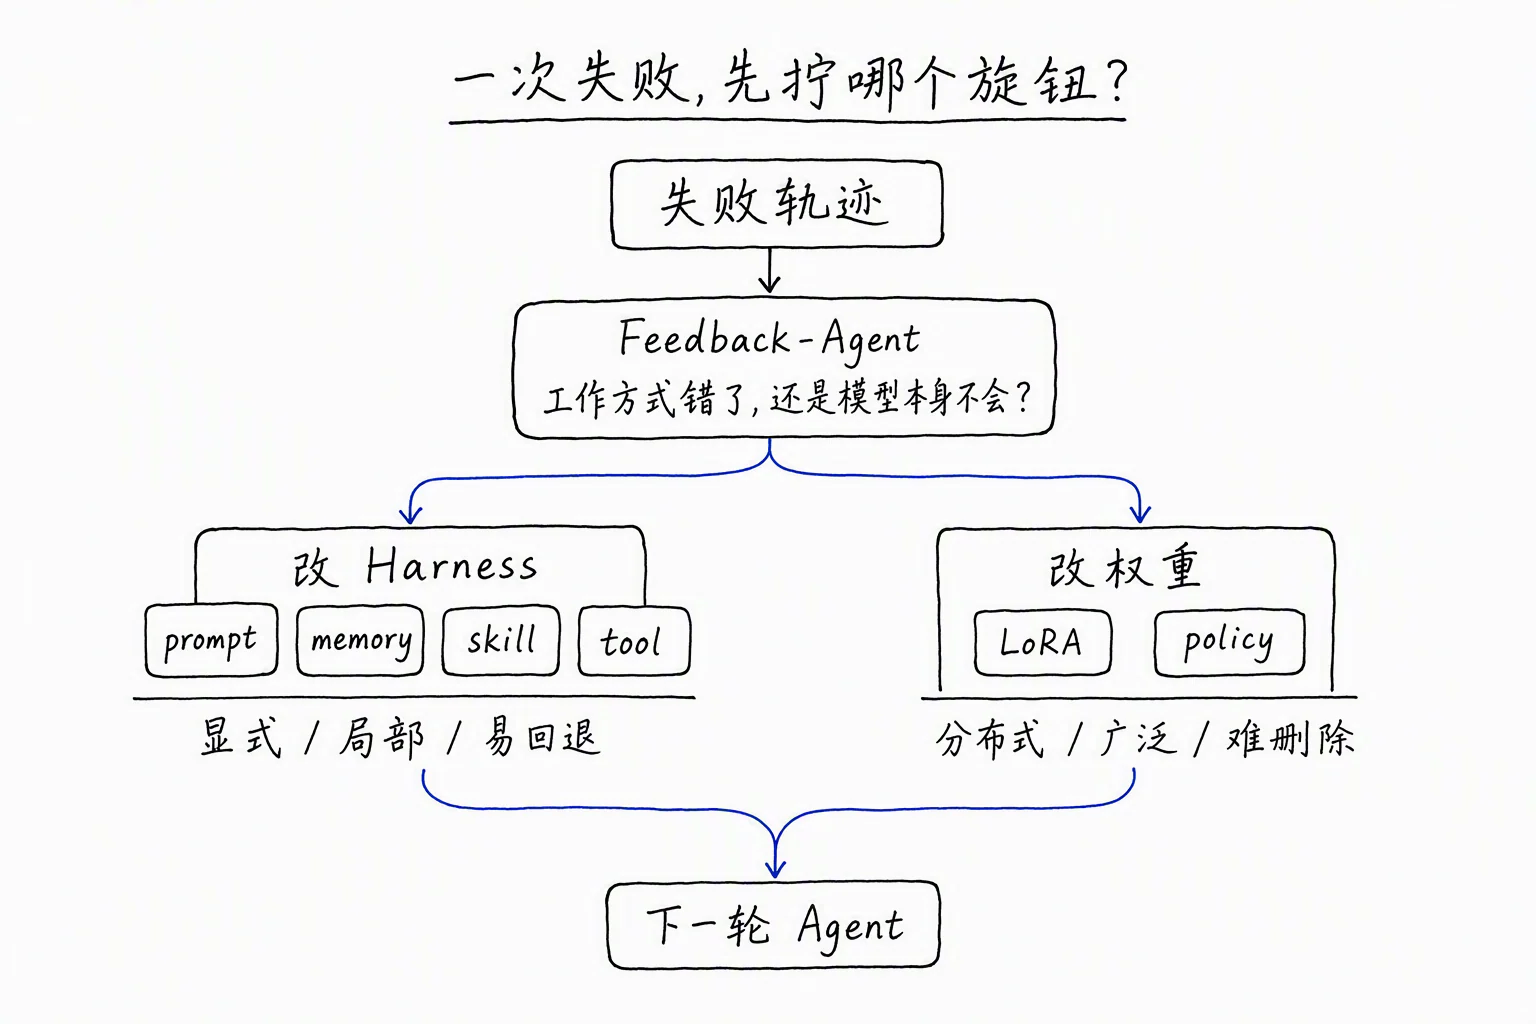
这篇讲权重这一层:模型怎样用自己生成的经验更新参数,这类更新为什么有能力门槛,以及为什么分数涨了以后,最难回答的问题是”到底哪部分变了”。
权重更新确实带来了额外收益
先确认一件事:把经验写进权重,值不值得。
SIA 在三个差异很大的任务上做了实验。中文法律分类里,联合更新权重和 scaffold 的 SIA-W+H 达到 70.1%,此前较好的结果是 45.0%。Triton GPU kernel 优化中,TriMul 算子从 1161 微秒降到 1017 微秒,快了 12.4%。单细胞 RNA 去噪任务里,mse_norm 从此前的 0.240 提到 0.289。
mse_norm 是归一化重建质量,越高越好,1.0 才是完美重建。名字里带 mse,却不能按普通均方误差理解成越低越好。这类容易读反的指标,恰恰说明权重层的收益需要逐个核对,而不是看个方向就下结论。
真正关键的是消融。三个任务上,SIA-W+H 都超过了只改 scaffold 的 SIA-H。权重这个旋钮带来了额外收益,不是系统图上的装饰。
这个结果也把两类经验分了开。
“调用工具前先检查输入格式”这种经验,适合留在 scaffold 里。它清楚、局部、能随时删除。而某类法律文本里哪些细微组合更像某个罪名,什么样的代码结构更容易生成高效的 GPU kernel,这些区别很难压成一条好用的 prompt。它们数量大、边界模糊、分布在大量样本里,训练能把这种知识写进参数,提示词很难。
代价也在这里。经验一旦写进权重,就很难再像审一份 SKILL.md 那样逐条翻看。它换来了收益,也换来了一段更难看清的黑箱。这条张力会贯穿整篇。
一个不需要标注的训练循环
要把权重层单独看清楚,需要一个循环里只动权重、别的都冻住的例子。EvoLMM 是一个合适的样本。
团队冻结了 Qwen2.5-VL 的主干,在同一个基座上挂了两组独立的 LoRA。一组叫 Proposer,负责从没有标注的图片里生成问题;另一组叫 Solver,负责对问题多次作答。整个训练不使用任何现成的问答标注,也不接外部 reward model,用到的只有约 6000 张原始图片。
没有标准答案,奖励从哪里来?答案藏在 Solver 自己的回答分布里。Solver 对同一个问题采样多次,系统从这些答案的一致程度算出一个连续的自一致性奖励,答得越稳定,奖励越高。Proposer 那一侧用答案的熵来构造一个带通式的奖励:问题太简单,Solver 每次都答对,熵太低;问题太难,Solver 全在乱猜,熵太高;只有落在中间、可解又不轻松的问题才拿到高分。
两组 LoRA 在同一个在线强化学习循环里一起变。Solver 每一步都更新,用带 token 级 KL 约束的 REINFORCE;Proposer 每五步更新一次。这套节奏带来一个自我推进的效果:Solver 变强以后,原来的问题逐渐显得太容易,Proposer 为了继续拿到中等难度的奖励,必须提出更难的问题;更难的问题又给 Solver 提供了下一轮的训练经验。课程没有写死在外部,它随着两组参数一起移动,在训练过程里不断重建。
这就是它属于 Model 层的原因。整个循环里持续变化的状态,是 Proposer 和 Solver 的 LoRA 权重。训练结束后,新的行为已经进入 Solver 的 adapter,下一次推理不必先检索一条 memory,也不用加载一份 SKILL.md。经验待在参数里,不占显式上下文。
结果也支持这套设计。Qwen2.5-VL-7B 在 ChartQA 上从 84.0% 提到 86.7%,MathVista 从 68.46% 提到 70.52%,八项主要评测全部提升。消融还显示,在这个循环里 LoRA 比 QLoRA 和全量微调都更稳定,QLoRA 受量化噪声干扰,全量微调则在没有监督约束时容易漂移。改动范围小,既保住了原模型的多模态能力,又让两个角色分开学习。
这里的”在线”只描述训练循环内部边采样边更新,不是部署之后按每个用户请求实时改权重。这个区别值得写清楚,因为很多”在线自进化”的说法会在这里含糊过去。
EvoLMM 也把权重层最难的问题摆了出来。自一致性只能衡量回答是否相同,不能保证回答正确。五次答案一致,可能只是同一个错误犯了五遍;模型也可能靠语言先验就凑出一致答案,根本没有认真看图。后续的 VISE 明确指出,这类自进化的多模态模型会出现 visual under-conditioning,也就是训练到后来越来越不依赖图像本身。
更麻烦的是评估。出题的和解题的一起变化以后,分数上涨可能来自能力真的增长,也可能只是两者越来越适应彼此,在一个共同收窄的分布里互相配合。要把这两种情况分开,评估就必须留一块不随训练一起移动的参照。这一点,后面还会再遇到。
自训练把监督搬到了哪里
EvoLMM 用自一致性替掉了标注。这不是孤例,而是权重层一条很宽的路线:模型自己生成训练经验,再用某种信号筛选或奖励这些经验,最后更新权重。这类工作通常被叫作 self-training、self-play 或 self-rewarding。名字很多,区分它们只需要看一件事:正确性信号从哪里来。
STaR 让模型生成推理过程,保留那些能得到正确答案的轨迹,再用这些轨迹训练下一轮。模型负责产出推理,数据集里的正确答案负责筛选。DeepSeek-R1-Zero 不再依赖人工写好的推理轨迹,但数学、代码这类任务本身有可验证的结果,强化学习就从这些结果里取奖励。这两者的正确性信号,都还站在模型外面。
SPIN 和 Self-Rewarding Language Models 把信号往模型内部挪了一步。SPIN 让当前模型和自己上一版生成的数据对照,学着区分自己的回答与人类示范,训练目标仍然指向原始的人类数据分布。Self-Rewarding 走得更远,让模型同时负责回答和打分,用 LLM-as-a-Judge 产生奖励,再迭代做 DPO。回答能力和打分能力可以一起提高,代价是错误的偏好也可能一起被放大——模型给自己的错误答案打了高分,就会朝那个方向越走越远。
TTRL 处理的是完全无标签的测试数据。模型对同一道题采样多次,用多数票估出一个临时答案,再把它当奖励做强化学习。论文报告,Qwen-2.5-Math-7B 只用无标签测试数据,在 AIME 2024 上的 pass@1 提高了约 211%。这个结果说明,初始模型的群体判断可以反过来训练它的单次回答;它也把边界写得很直白:多数票整体偏错的时候,训练只会把错误变得更稳定。
Absolute Zero 连外部数据也拿掉了。一个模型同时出题和解题,代码执行器负责检查题目是否有效、答案是否正确。模型自己扩展训练课程,执行器把整个搜索钉在可验证的结果上。这条路线很接近”自己给自己编教材”,适用范围也因此被验证器框死。代码可以执行,开放式的研究判断没有同样便宜的裁判。
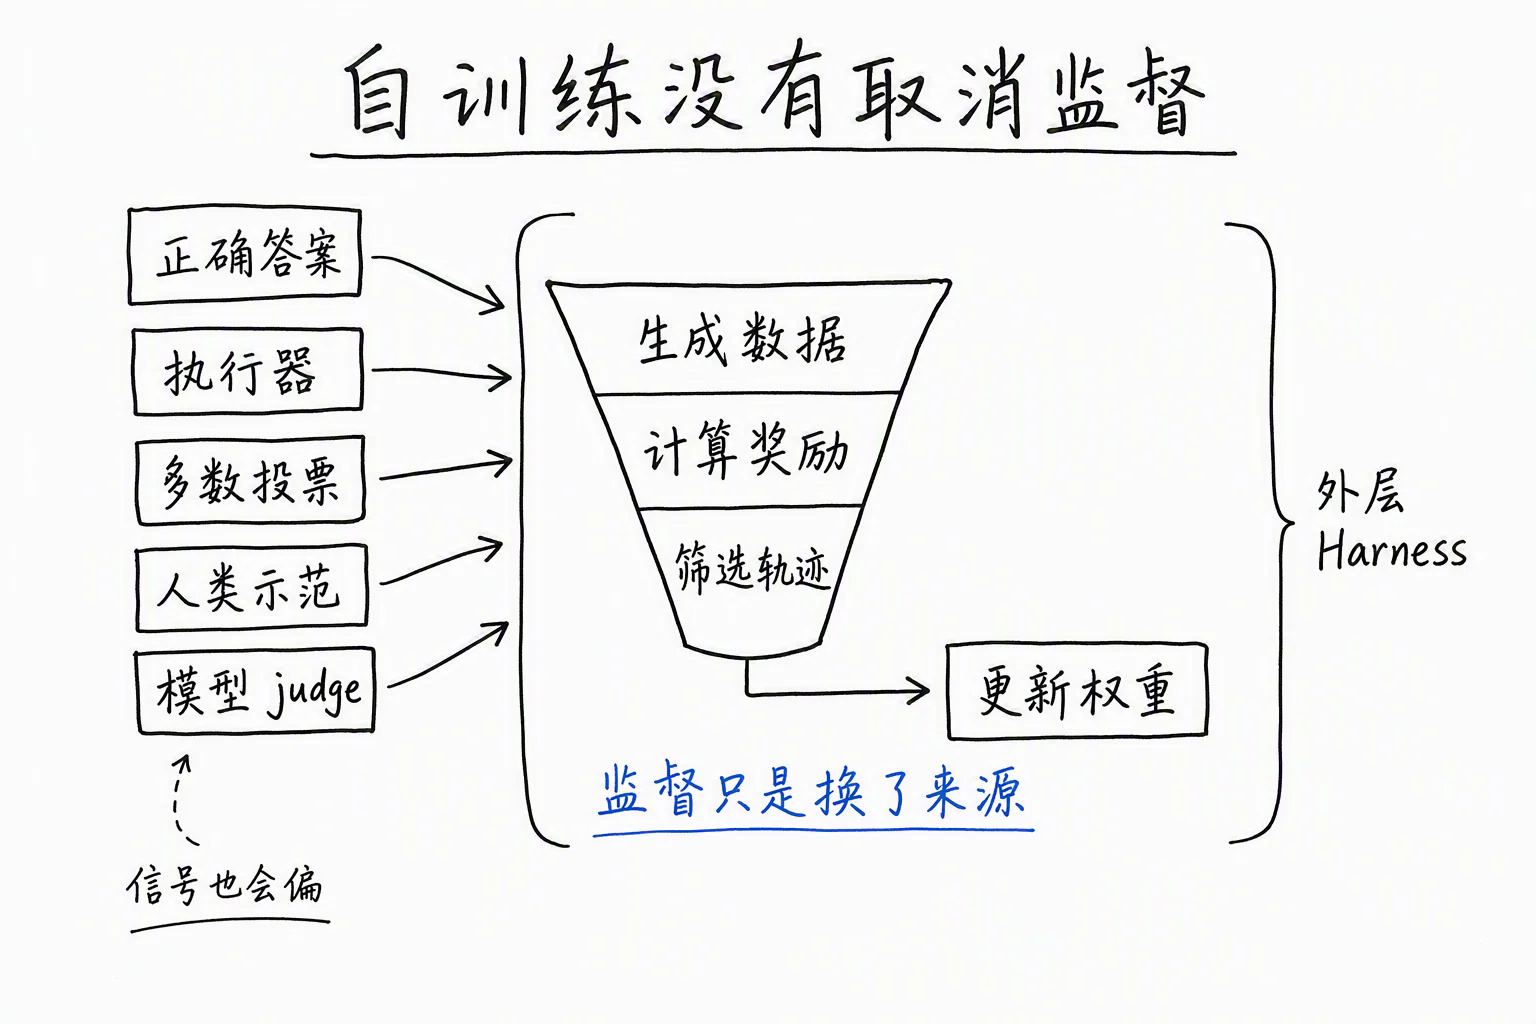
把这一串方法排在一起,会看到一个共同点:它们都没有取消监督。监督被搬到了别处——搬进正确答案、执行器、多数投票、人类示范分布,或者一个模型 judge 里。数据怎么生成、奖励怎么算、哪些轨迹被保留、失败以后回到哪个 checkpoint,这些决定绝大多数发生在模型权重之外。
也就是说,权重自训练的那层外层循环,本身就是一套 Harness。它同时决定了推理时模型怎样工作,以及训练时模型拿到什么经验、该相信哪个反馈。权重更新表面上最自主,骨子里最依赖外面这套组织。
权重这个旋钮有能力门槛
权重更新有额外收益,也有前提。收益不是打开旋钮就自动到手的。
Continual Harness 把内外两层分得很清楚。内层有一个 Refiner,在一局不重置的长任务里高频修改四类状态:prompt、子 Agent、skill 和一棵记忆树。环境不重置,上一轮结束的位置就是下一轮的起点。外层拿持续产生的轨迹交给一个过程奖励模型打分,低质量的片段由更强的教师模型重新标注,再用软 SFT 更新策略模型的权重。
在能力较强的 Gemini Pro 档位上,这套系统用 130 美元的中位成本,完成了 100% 的宝可梦通关里程碑。作为对照,一个极简 baseline 花了 215 美元,完成度 98%。成本少了约 40%,结果没有打折。
换到更弱的 Flash-Lite 档位,方向反了过来。极简 baseline 还能做到约 20%,加上 Continual Harness 之后反而只剩 3% 到 13%,成本还更高。
同一套系统,强模型上省钱又达标,弱模型上却把成绩拖垮。原因在于,这套内外两层的机制会额外引入指令、状态和决策分支。模型足够强的时候,这些结构帮它把长任务拆开、把经验攒住;模型能力不够的时候,它们只是压在肩上的额外负担,模型连基本任务都顾不过来,更别说消化教师信号。
这和 Harness 层反复出现的那条规律是同一件事:收益不是单调的。太弱的模型读不懂、也用不动更新,太强的模型已经贴近天花板、更新空间有限,中间那一段才最容易吃到红利。联合更新权重同样有明确前提——系统至少要有能力判断失败、使用反馈,并把教师信号转成更好的行为。达不到这个门槛,权重旋钮拧了也是负收益。
把评估器和记忆也搬进权重的尝试,同样绕不开外部依赖。EvoRubrics 在同一个冻结基座上挂了 Policy 和 Rubric Generator 两组 LoRA,每个训练步先生成答案和评分标准,由外部 judge 形成交叉评分矩阵,再顺序用 GRPO 更新两组 adapter。它比 EvoLMM 更直接地研究”策略和评估器一起变”这个问题,但完整版本依赖 DeepSeek-V3.2 当 judge、DeepSeek-R1 做 warm start,还要一个 golden rubric 当锚点;所谓自监督的版本,只是移除了参照评分标准,没有移除外部 judge。TMEM 则在单个 episode 内把历史蒸馏成监督信号,通过轻量的在线更新写进一组快权重 LoRA,是”显式记忆走向参数记忆”的一座直接的桥。这些工作让越来越多的角色进入权重,可无论进去的是评估标准还是记忆,外面那个 judge、那位教师、那个锚点都还在。监督换了位置,没有消失。
分数涨了,到底哪部分变了
能力门槛只是第一层困难。权重层更棘手的地方在归因。
Harness 的错误通常写在文件里。某条 prompt、某段 memory、某个 skill 引发了问题,可以找到对应的条目,看它是什么时候加进来的,然后单独删掉。权重更新不给这种方便。它把经验分散进大量参数,只在某一类输入上才露出结果。训练 checkpoint 可以整体回退,可”删掉这一条错误经验”没有同样清楚的接口——你没法只撤销模型学到的某一个坏习惯,而保住其余全部。
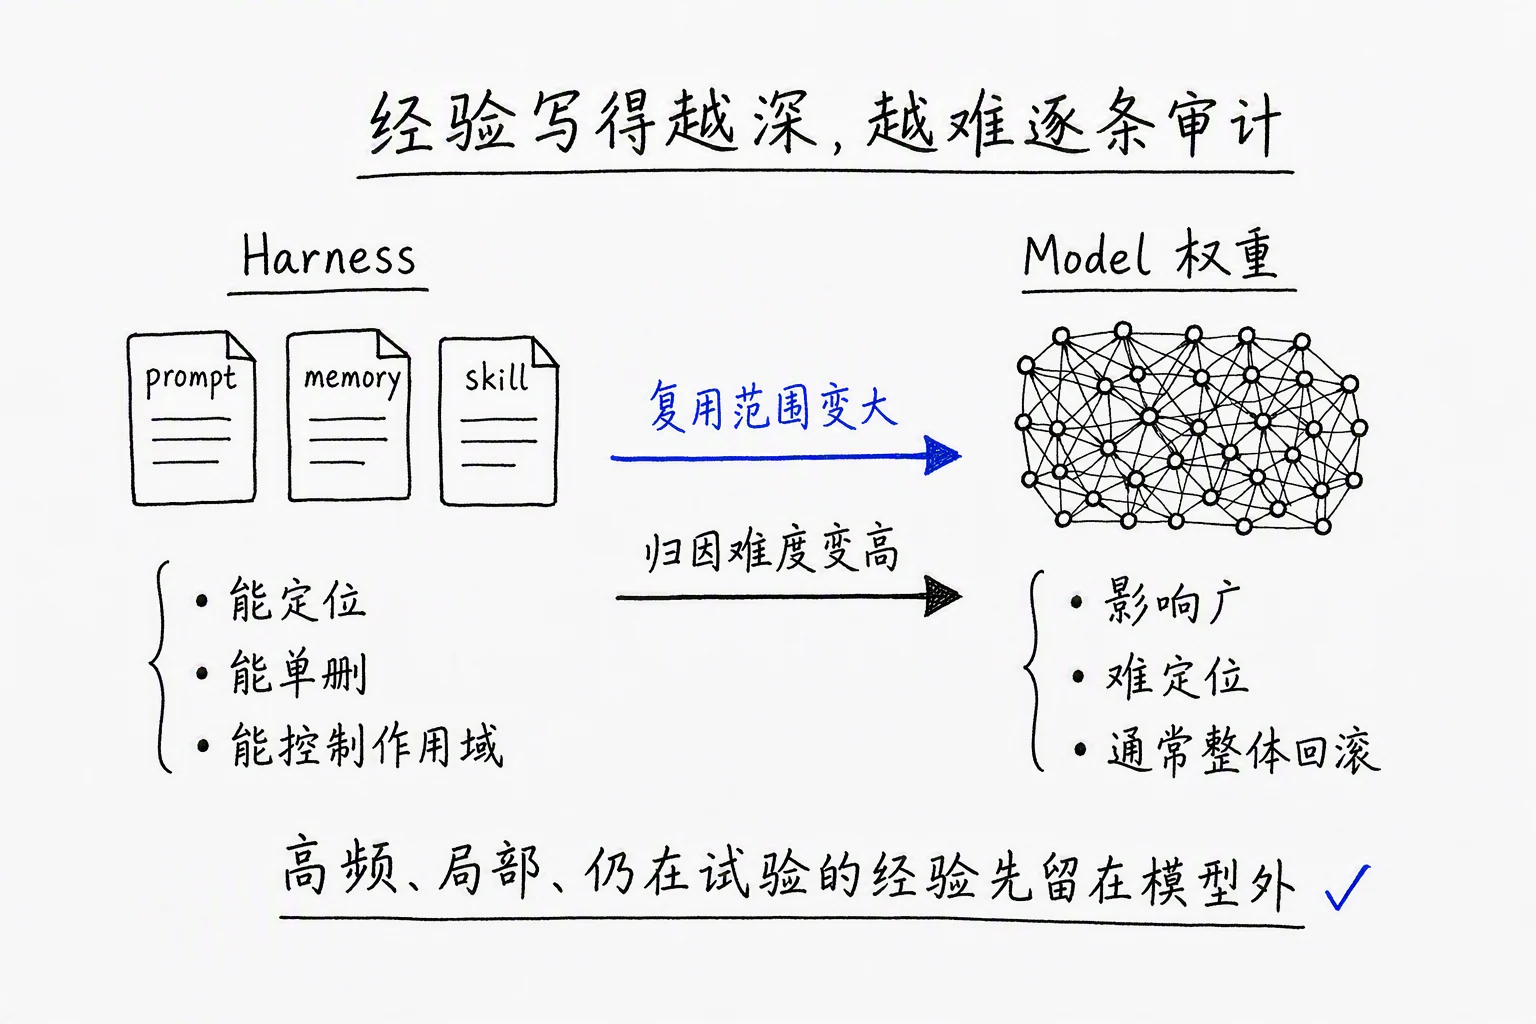
分数上涨本身也不能直接告诉你模型学到了什么。它可能获得了更好的推理策略,也可能只是记住了评测的分布,还可能找到了奖励函数的一个漏洞。自训练越依赖模型自己生成的数据和评分,这个问题越尖锐。而一旦系统还要负责设计下一轮训练,当前这点偏差就会顺着循环继续传给后面的版本,越滚越大。
可解释性能帮的忙,目前只照亮其中很短的一段。
Thinking Machines 的 On-Policy Distillation 提供了一个局部窗口。学生模型先采样自己的推理轨迹,教师再对这些 token 逐个打分。研究者发现,反向 KL 偏高的 token,常常落在推理即将分叉的位置——换掉这一个 token,后面整条路径就可能完全不同。他们把这种位置叫作 forking token。这让”教师到底在纠正什么”稍微具体了一点:训练不是平均地抹平整段答案,它可以集中修正那几个改变路径走向的关键选择,而且这么做的成本远低于完整的强化学习。
Anthropic 的 J-space 从另一个方向读模型内部。J-lens 去找那些会让模型未来更可能说出某个词的活动模式,把它们组织成所谓的 J-space。当模型读到一段带 prompt injection 的搜索结果时,内部的 injection、fake 这类模式会先亮起来,说明它在开口输出之前,已经在内部识别到了某些结构。这类结果能证明某些内部模式和后续输出之间存在因果关系,但它不能证明模型有意识——Anthropic 在原文里明确守住了这条边界。
这些工作把训练、内部表示和外部行为之间的连线拉近了一点。离”模型清楚自己在怎样改自己、并且知道怎样安全地改”,还有很长一段距离。归因没解决,权重层的自我改进就始终缺一块最要紧的可验证性。
高频经验为什么先留在模型外
把这几件事放在一起,会得到一个相当稳妥的工程分工。
SIA 证明了权重和 scaffold 联合更新有额外价值,权重不是可有可无的旋钮。Continual Harness 又证明这份价值有能力门槛,模型不够强的时候,拧这个旋钮反而是负收益。自训练那一整条路线则说明,权重更新自始至终依赖外层的数据、奖励和验证机制,最自主的一层其实最依赖外面的组织。
顺着这三点,合理的做法是让经验分层沉淀。高频、局部、还在试验阶段的经验,先留在 Harness 里。它在那里可以附上证据、限制作用域、单独回滚,错了也好收拾。等一类经验在多个任务上反复成立、确认稳定,再决定要不要通过训练把它写进权重。这样不会解决权重层的全部问题,但至少让错误在进入黑箱之前,先在看得见的地方待够久。
这也回到了整个系列反复强调的那条脊柱:判断要放在尝试之外。在权重层,这句话的分量更重。因为出题者和解题者会一起移动,评估器和策略会一起更新,如果连最终的裁判也随着训练一起变,分数就失去了参照。可信的权重层实验,必须留一块不随训练共同移动的评估集,让它独立于那个正在自我改进的循环。
严格意义上的 RSI,门槛还要再高一层。它不只要求下一代模型更强,还要求下一代模型更擅长设计再下一代的训练。一个模型可以反复生成数据、更新权重、刷高分数,但只要数据流程、奖励函数和训练算法始终由人固定,它做的就还是 self-training——生产下一代系统的方法本身没有变强。权重变了,造权重的方法没变,这中间隔着的正是”递归”两个字。
模型能用自己生成的经验更新参数,这件事今天已经能跑起来。让这些更新可验证、可归因、可回退,仍是未解的工程问题。在这些问题被解决之前,把高频经验留在模型外面,是一种诚实的克制。